La RAG, acronimo di Retrieval-Augmented Generation, è una tecnica che permette a un modello linguistico di utilizzare informazioni recuperate da fonti esterne mentre genera una risposta. Il modello non si basa quindi soltanto su ciò che ha appreso durante l’addestramento, ma riceve anche passaggi selezionati da documenti, database o altri archivi.
1. Le origini della RAG
Il termine RAG è stato introdotto nel 2020 da Patrick Lewis e dai suoi collaboratori e si è diffuso negli anni successivi grazie allo sviluppo degli LLM e degli strumenti che ne hanno facilitato l’implementazione.
I problemi che la RAG cerca di affrontare sono principalmente due: da un lato mitigare le allucinazioni degli LLM fornendo informazioni recuperate da fonti esterne e verificabili; dall’altro permettere al modello di utilizzare informazioni aggiornate senza doverlo riaddestrare, operazione lunga e costosa.
2. Come funziona un sistema RAG
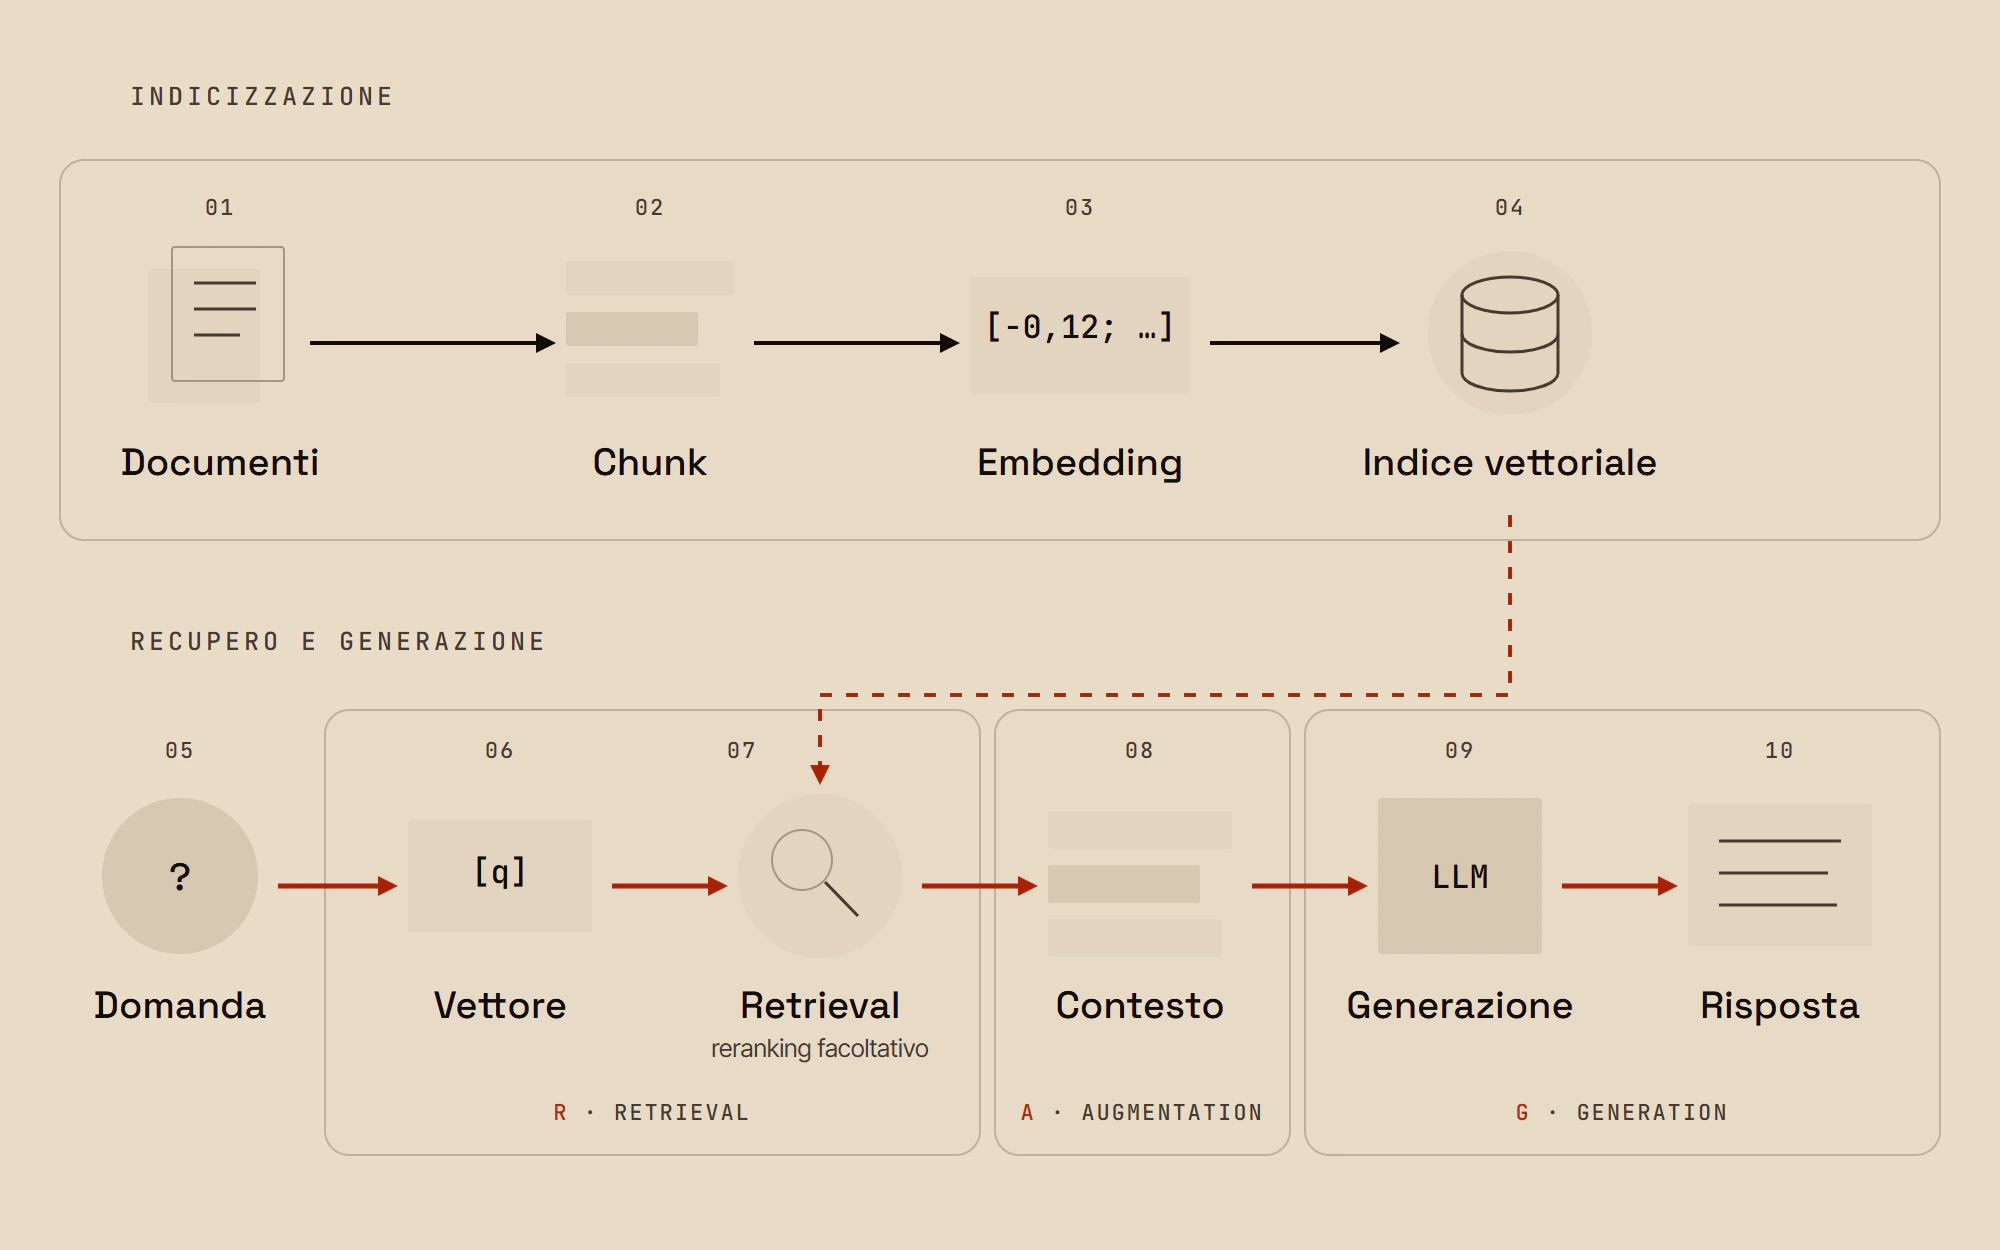
Un sistema RAG è una piccola catena di montaggio che parte dai documenti grezzi e finisce con una risposta in linguaggio naturale. Il modo migliore per capirne il funzionamento è analizzare i vari pezzi che compongono questa lunga catena, uno alla volta e nell’ordine in cui entrano in gioco:
- preparazione dei documenti e chunking
- embedding
- indicizzazione
- retrieval
- reranking (facoltativo)
- costruzione del contesto
- generazione.
Le decisioni prese in ogni passaggio influenzano quelli successivi, tanto che un errore iniziale può manifestarsi soltanto nella risposta finale.
3. Cosa sono i chunk
I chunk sono le porzioni di testo in cui vengono suddivisi i documenti prima dell’indicizzazione. In un sistema RAG rappresentano le unità che verranno trasformate in embedding, archiviate e recuperate durante la ricerca.
Il processo parte generalmente da documenti in formati diversi, come PDF, DOCX ed EPUB. Dopo averne estratto il testo, il sistema lo divide in blocchi lunghi di solito qualche centinaio di token. Il numero di parole corrispondente può variare in base alla lingua e al sistema utilizzato per dividere il testo in token.
Perché li spezziamo? Per due motivi.
Il primo dipende dai limiti dei modelli coinvolti, perché sia i modelli di embedding sia gli LLM possono elaborare soltanto un determinato numero di token alla volta.
Il secondo, più importante, riguarda la capacità di trovare un’informazione specifica, per esempio all’interno di un libro di 400 pagine.
Un blocco piccolo permette generalmente un recupero più mirato. Il rovescio della medaglia è che, spezzando il testo, si rischia di perdere il contesto.
La divisione può essere effettuata in modi diversi. Il metodo più semplice consiste nel contare caratteri o token, anche a costo di interrompere una frase. Altri sistemi cercano invece di rispettare la struttura del documento, utilizzando titoli, paragrafi e frasi come possibili punti di separazione.
Esistono inoltre metodi semantici, che calcolano gli embedding di frasi consecutive e inseriscono un nuovo confine quando la loro somiglianza diminuisce sensibilmente. Altri sistemi affidano la divisione a un modello generativo, che legge il documento per intero oppure, se è troppo lungo, lo elabora in più porzioni e individua i punti nei quali cambiano l’argomento o la funzione del testo.
Il chunking basato su LLM potrebbe sembrare la soluzione migliore, perché il modello non si limita a contare caratteri o token, ma interpreta il contenuto del documento. Una suddivisione coerente per un lettore, però, non è necessariamente la più efficace per il retrieval. Il modello può riunire in un solo chunk un ragionamento completo ma troppo lungo, oppure separare un’informazione dal termine preciso con cui verrà cercata.
Il risultato dipende inoltre dal modello, dalle istruzioni e dalla configurazione utilizzata. Elaborare tutti i documenti richiede più tempo e risorse e, quando un testo supera la finestra di contesto, deve essere suddiviso in più porzioni prima di poter essere analizzato. In questi casi il problema del confine non scompare, ma viene semplicemente spostato a una fase precedente. Per documenti ben strutturati, un sistema più semplice che rispetta titoli, paragrafi e frasi può quindi essere più stabile, economico e altrettanto efficace.
Non esiste una dimensione o una strategia giusta in assoluto. La scelta deve essere verificata sulla struttura dei documenti e sul tipo di domande alle quali il sistema dovrà rispondere.
3.1. La sovrapposizione (overlap)
Per non far perdere del tutto il collegamento tra un chunk e il suo successivo si utilizza una tecnica di overlap. I pezzi non vengono tagliati di netto uno dopo l’altro, ma si sovrappongono. Il secondo chunk ricomincia qualche decina di parole prima rispetto a dove finisce il primo, così le due porzioni condividono un pezzetto di testo.
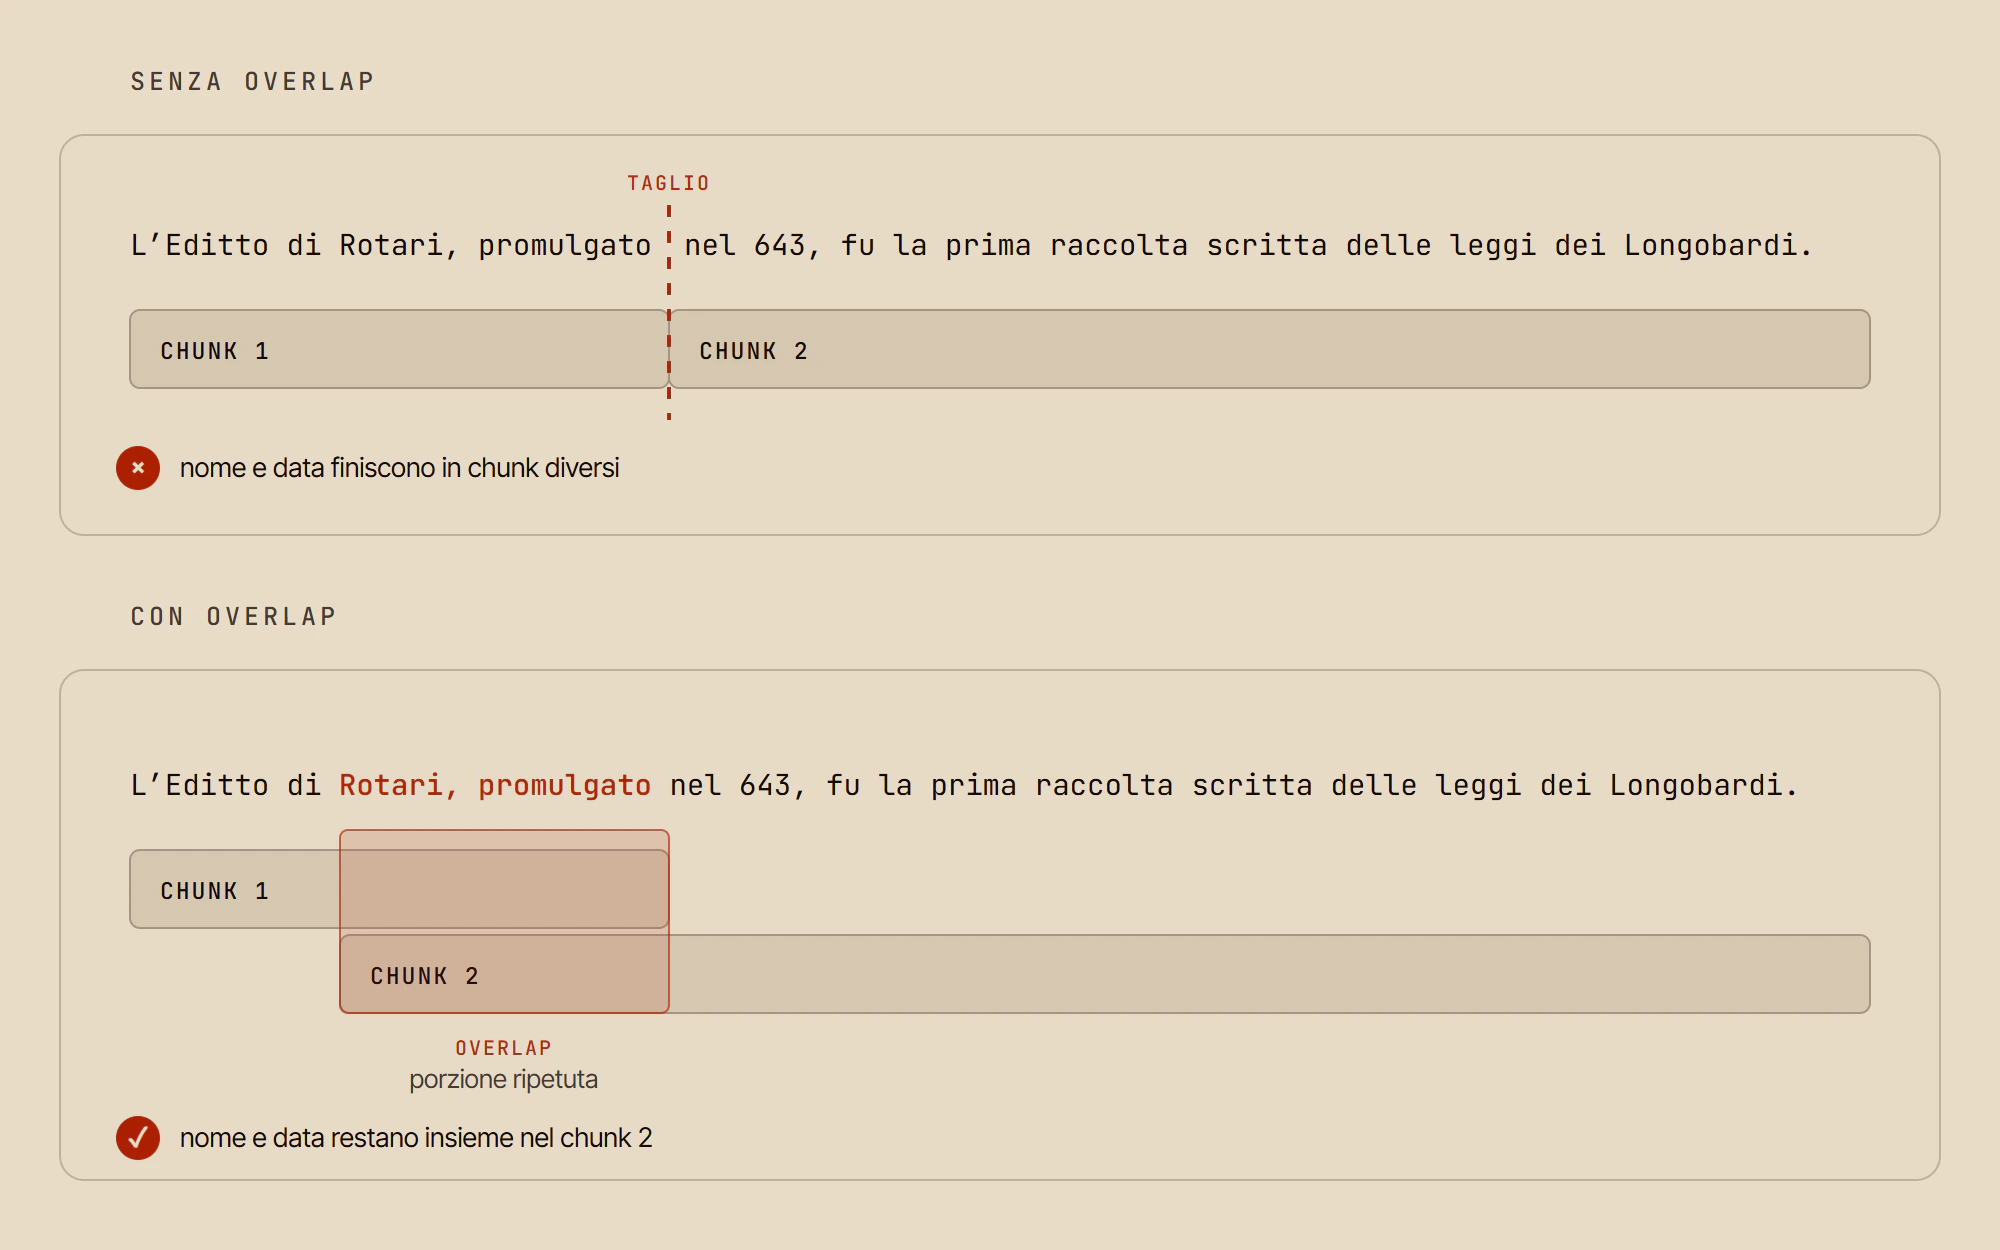
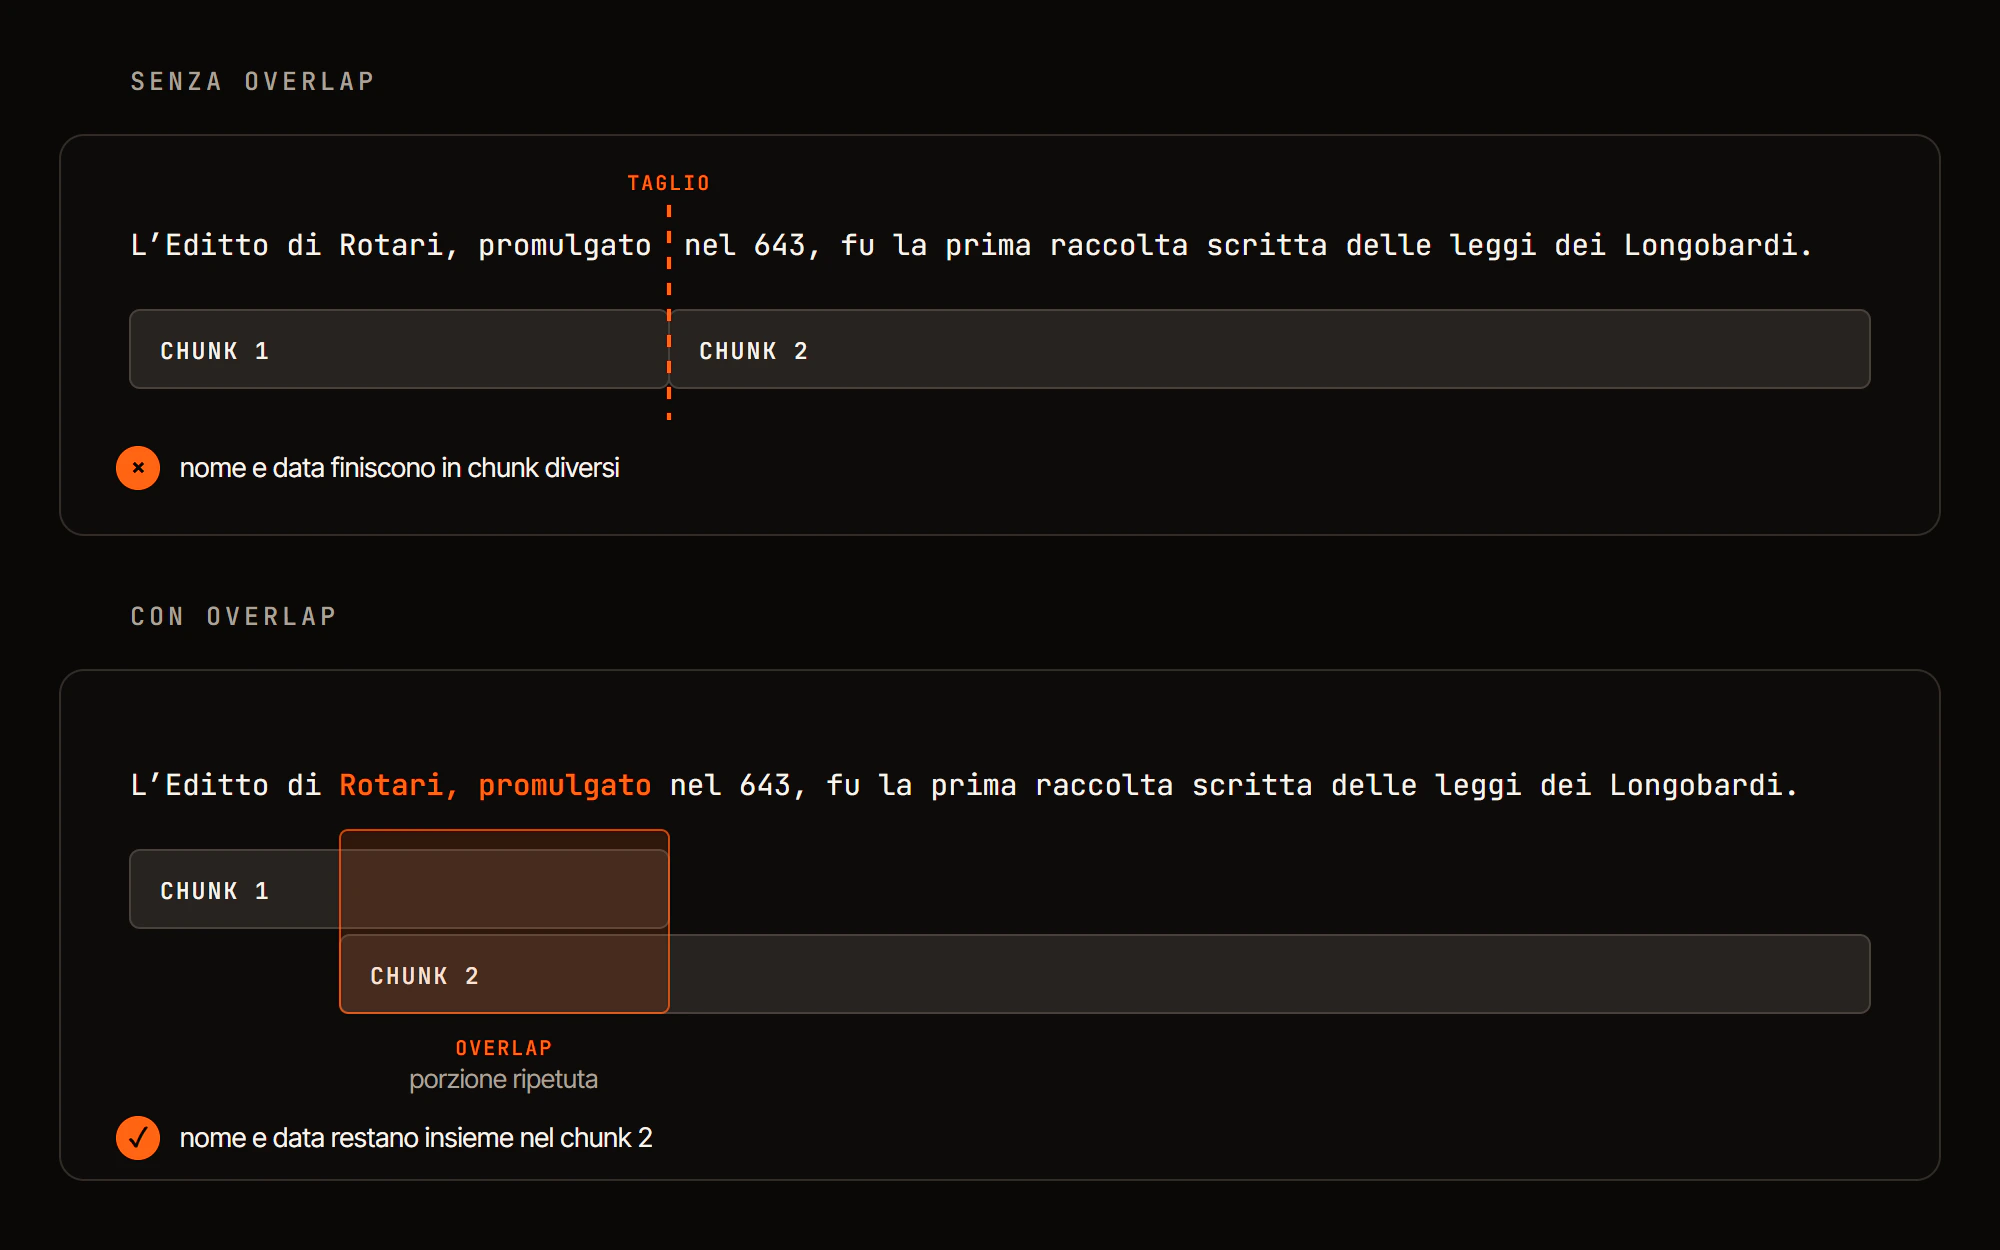
Di solito si parte da un overlap pari a circa il 10–20% della lunghezza del chunk, ma non esiste un valore adatto a tutti i casi. Su pezzi da 350 parole, per esempio, si potrebbero sovrapporre una quarantina di parole. Anche questo parametro va però verificato in base ai documenti e alle ricerche previste.
L’overlap comporta però due costi. Il primo è che aumenta il numero dei dati da elaborare e conservare, rendendo più grande il database vettoriale. Il secondo riguarda il retrieval, che analizzeremo più avanti. Poiché due chunk vicini condividono parte del testo, possono comparire entrambi fra i risultati, occupando più posizioni con contenuti quasi identici e riducendo la varietà delle informazioni recuperate.
In ogni caso, l’overlap non risolve il problema della perdita di contesto, ma si limita a ridurne gli effetti. Mantiene la continuità per qualche decina di parole intorno al punto di separazione, ma non può conservare il senso complessivo di un intero capitolo.
Esistono anche tecniche più avanzate, come il late chunking, che cercano di conservare una parte maggiore del contesto. Per comprenderne il funzionamento, però, dobbiamo prima vedere che cosa sono gli embedding e come funziona il pooling.
4. Cosa sono gli embedding
Gli embedding sono rappresentazioni numeriche del testo. Un modello di embedding trasforma una parola, una frase o un intero chunk in un vettore, cioè in una lista di numeri che ne rappresenta il significato all’interno di uno spazio matematico.
Il termine inglese embedding significa letteralmente “immersione”: un contenuto viene collocato, o immerso, in uno spazio formato da numeri. Per esempio, la frase «il gatto sul tavolo» potrebbe produrre un vettore come questo: [-0,12; 0,47; -0,03; 0,21; ...].
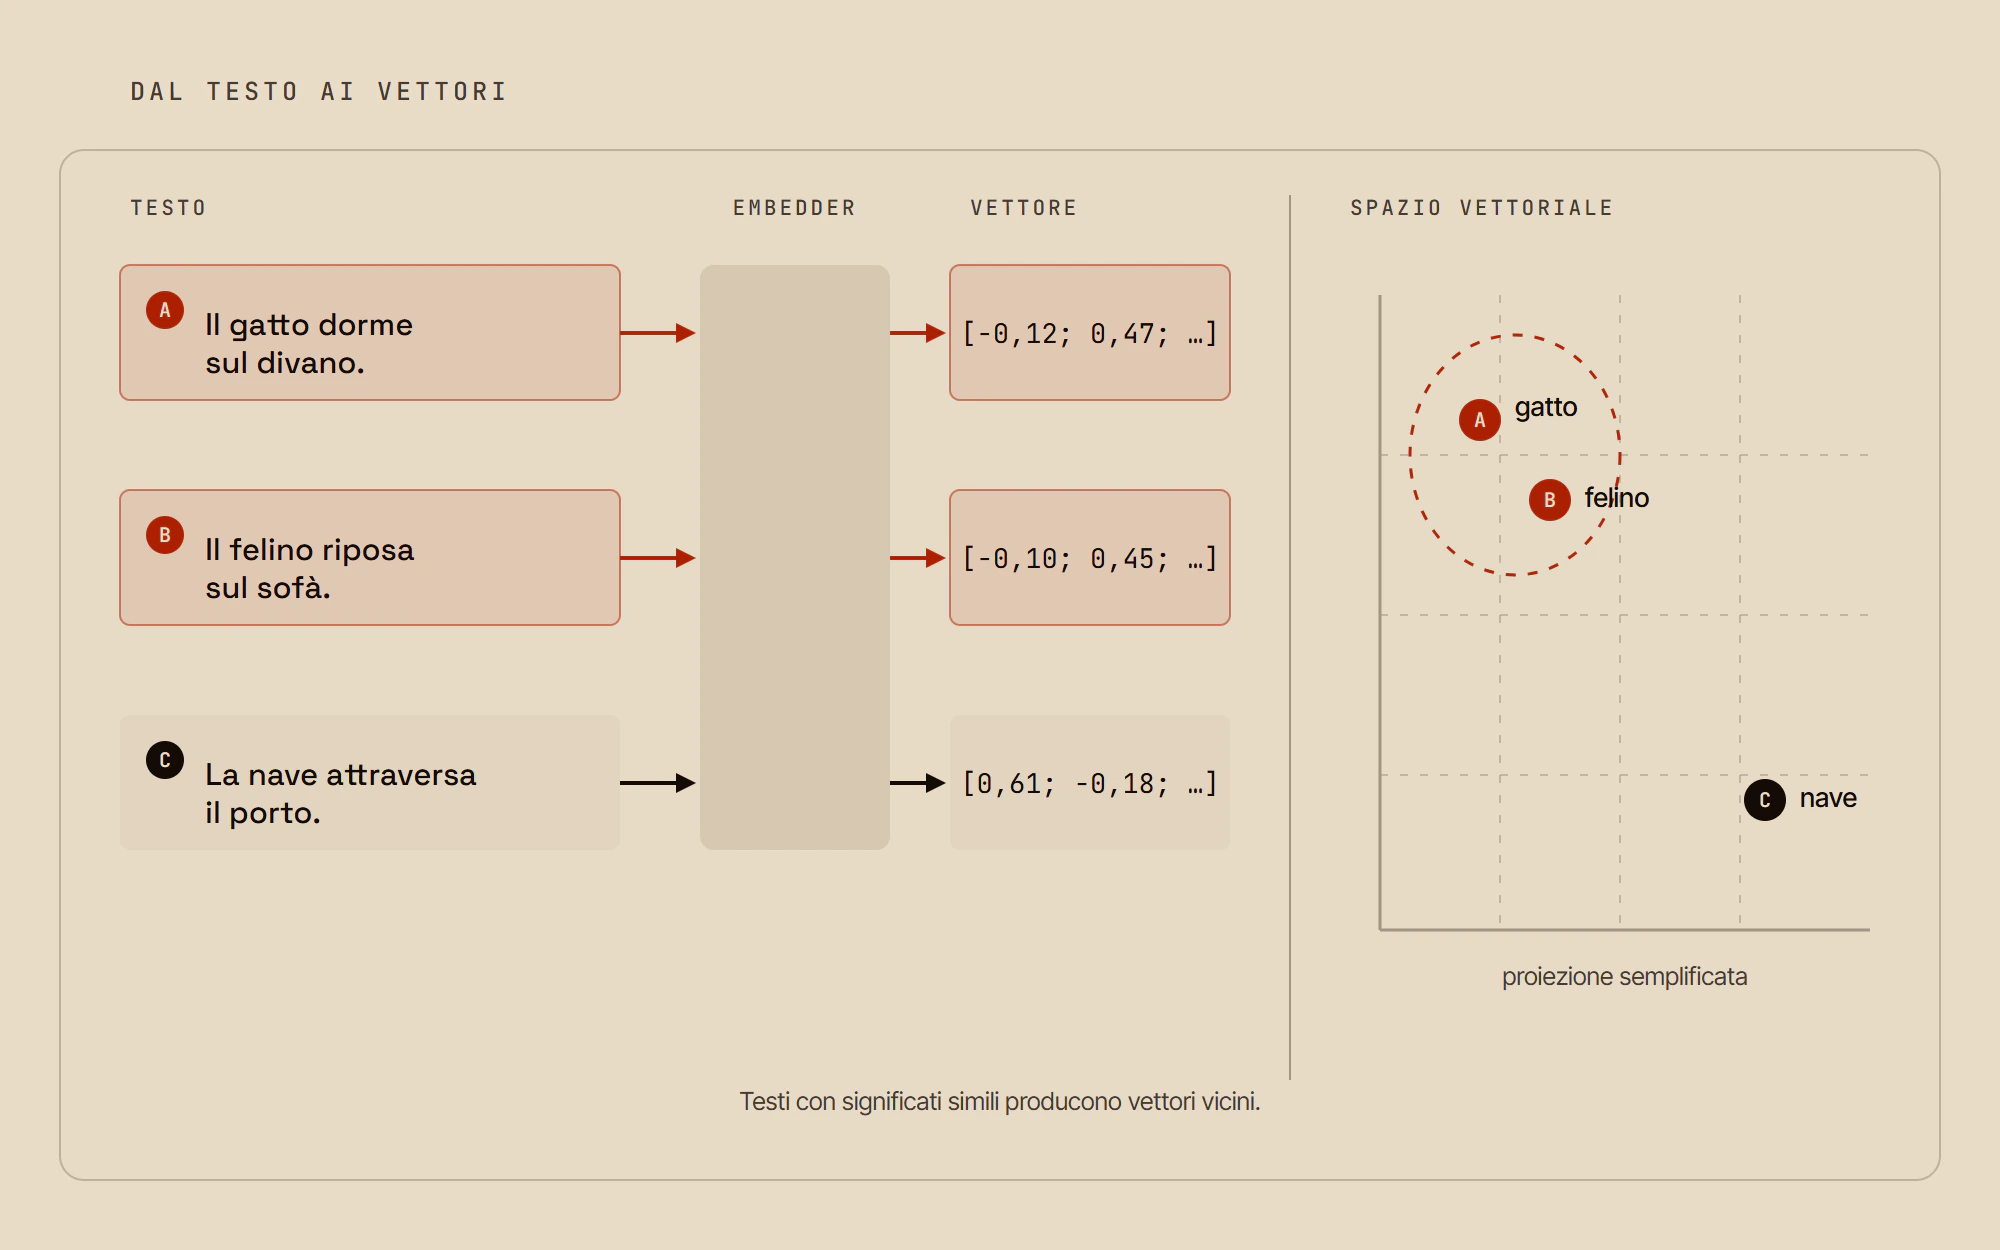
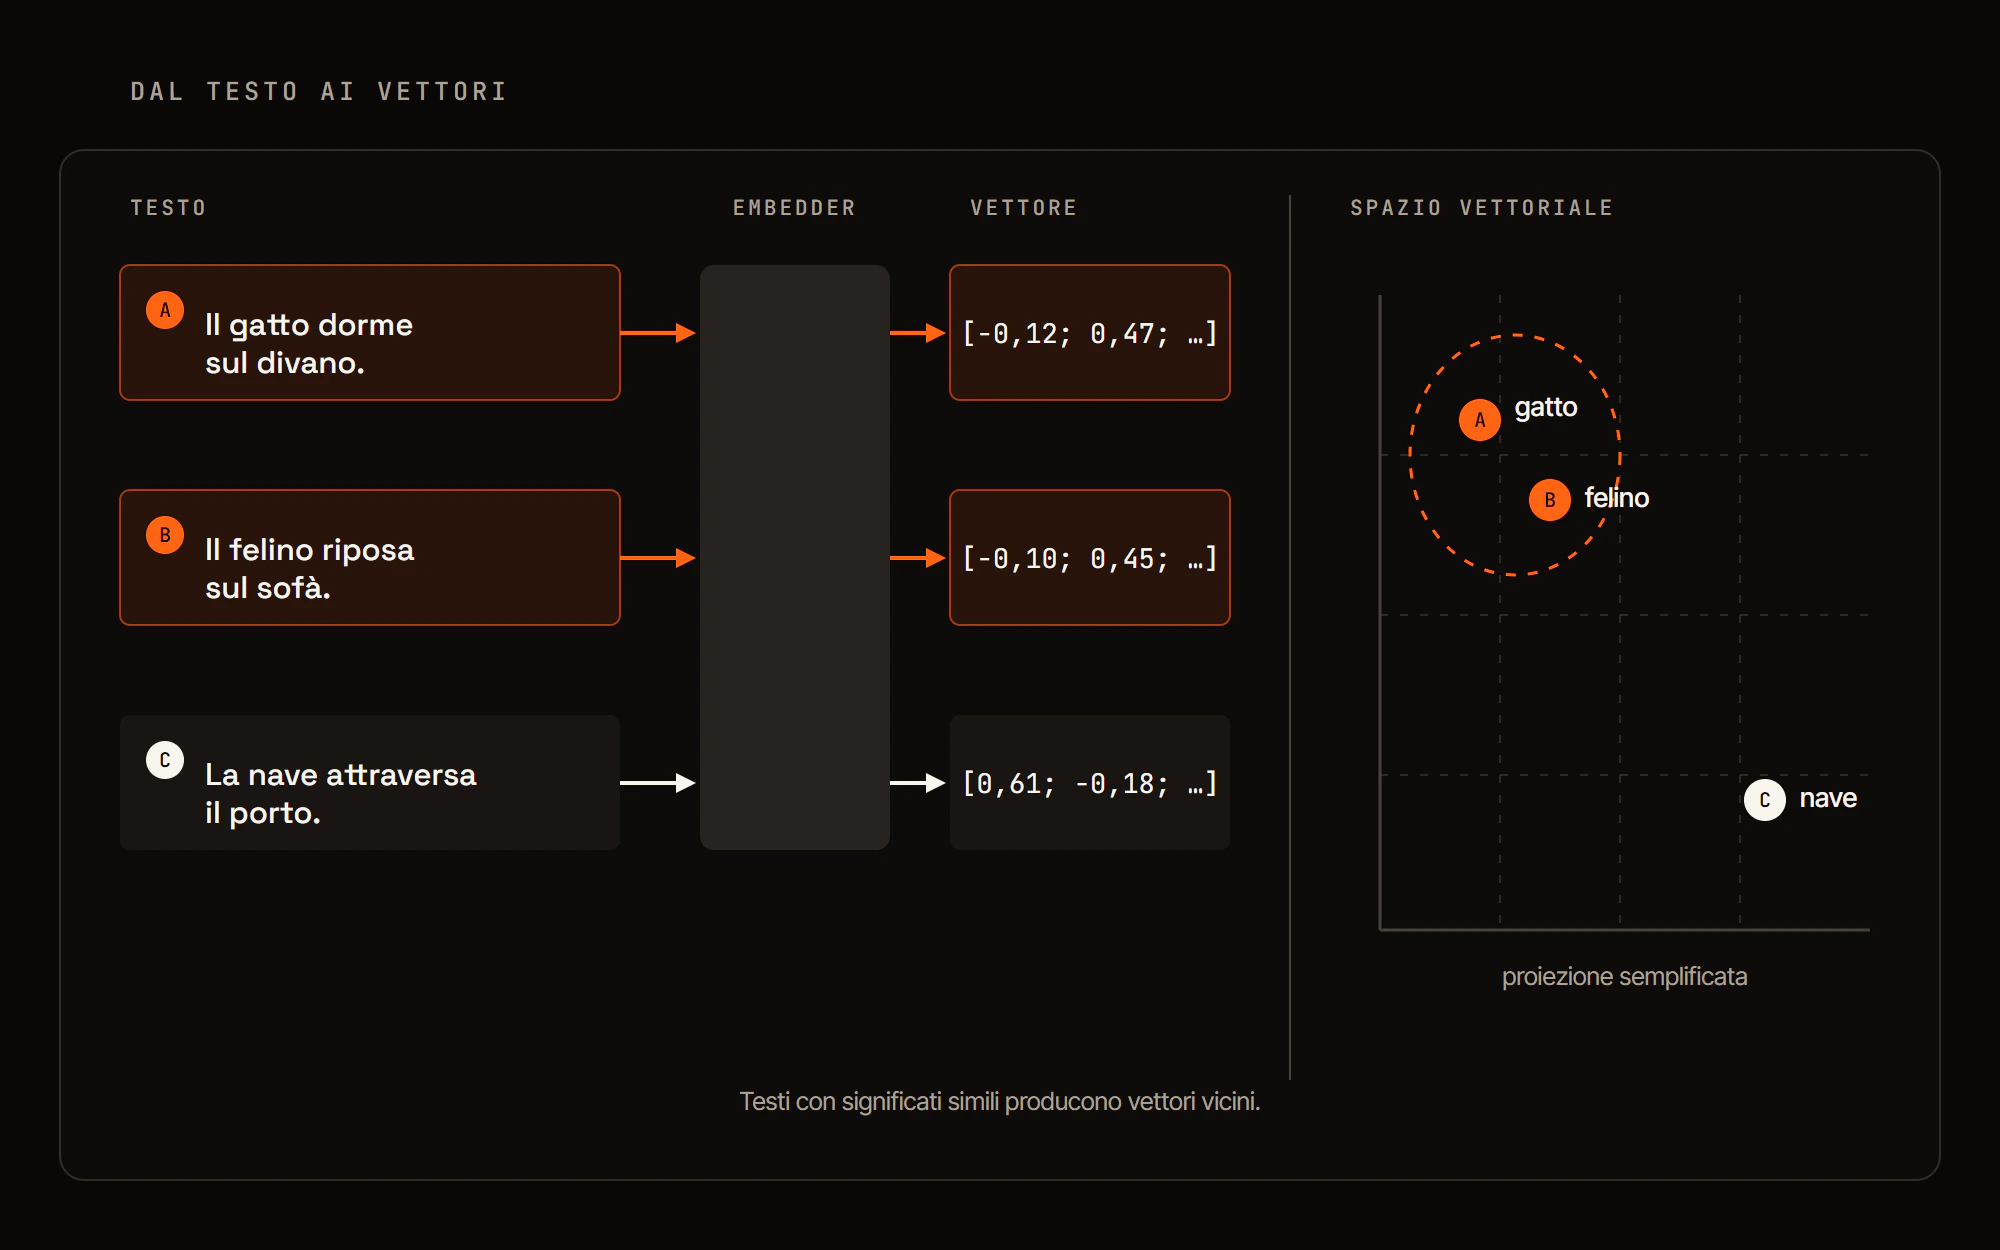
E quanti sono questi numeri? La dimensione del vettore non dipende dalla lunghezza del chunk, ma dal modello e dalla configurazione utilizzata. Multilingual-e5-large, per esempio, produce vettori di 1024 valori. Qwen3-Embedding-4B può arrivare a 2560, ma consente anche di scegliere dimensioni inferiori. Una volta stabilita la dimensione, tutti i vettori prodotti avranno lo stesso numero di valori, indipendentemente dalla lunghezza del testo inserito.
La dimensione dei vettori ha conseguenze soprattutto sulle risorse necessarie. Vettori più grandi occupano più spazio e richiedono più calcoli durante la ricerca; quelli più piccoli sono più leggeri e veloci. Un numero maggiore di dimensioni offre al modello più spazio per rappresentare le caratteristiche del testo, ma non garantisce automaticamente risultati migliori. La qualità dipende soprattutto da come il modello è stato addestrato e dalla sua adeguatezza al compito.
Perché si trasformano le parole in vettori numerici? Per poter misurare la somiglianza. Due testi che parlano della stessa cosa producono liste di numeri simili fra loro, anche se usano parole diverse. «Il gatto dorme sul divano» e «il felino riposa sul sofà» finiscono vicini, pur non avendo quasi nessuna parola in comune. Si cerca per significato, non per parole esatte.
4.1. Come funziona un modello di embedding
Un modello di embedding, chiamato anche embedder, riceve un testo e lo trasforma in un vettore numerico che ne rappresenta il significato. Per farlo, divide il testo in token, li elabora tenendo conto del loro contesto e produce una rappresentazione che può essere collocata in uno spazio vettoriale.
A differenza di un modello generativo, un embedder non produce una sequenza di parole e a parità di testo, modello e configurazione, restituisce normalmente lo stesso vettore.
Per comprendere questo meccanismo, possiamo pensare alle coordinate geografiche. Data una città, possiamo indicarne la posizione attraverso la latitudine e la longitudine. Un embedder compie un’operazione simile, ma invece della posizione geografica calcola una sorta di posizione del significato.
Ciascun numero del vettore rappresenta una coordinata in una delle dimensioni di questo spazio. A differenza della latitudine e della longitudine, però, queste dimensioni non hanno generalmente un significato comprensibile se considerate singolarmente, ma è il loro insieme a determinare la posizione del testo.
Lo spazio vettoriale è l’insieme di tutte le posizioni possibili. Il vettore prodotto dal modello contiene le coordinate che collocano il testo all’interno di questo spazio. Testi con significati simili tendono a occupare posizioni vicine e possono quindi essere trovati confrontando le rispettive coordinate.
Questo spiega due cose che altrimenti potrebbero sembrare arbitrarie. La prima è che il modello funziona anche con frasi che non ha mai incontrato, perché non le cerca in un elenco, ma ne calcola la rappresentazione. La seconda è che cambiare modello obbliga a ricalcolare tutti i vettori, perché cambia il sistema di coordinate. Le vecchie posizioni non sono sbagliate, ma appartengono a uno spazio diverso. Per questo i vettori prodotti da modelli differenti non possono essere confrontati direttamente.
4.2. Quale embedder scegliere
Non esiste un embedder migliore in assoluto. La scelta dipende dalla lingua dei documenti, dalla qualità richiesta, dalla lunghezza dei testi, dalle risorse disponibili e dal tipo di ricerca che si vuole realizzare. Per lavorare con l’italiano o con più lingue, alcuni modelli da prendere in considerazione sono Qwen3-Embedding, BGE-M3, multilingual-e5-large, gte-multilingual-base ed EmbeddingGemma-300M.
La famiglia Qwen3-Embedding è disponibile nelle versioni da 0,6, 4 e 8 miliardi di parametri. Questi modelli hanno ottenuto risultati molto alti nei benchmark multilingue, supportano testi lunghi e permettono di scegliere la dimensione finale dei vettori. Le versioni più grandi richiedono però molta memoria e potenza di calcolo. La versione da 0,6 miliardi rappresenta un compromesso più accessibile.
Multilingual-e5-large è un modello meno recente, ma ormai collaudato e ampiamente supportato dalle librerie disponibili. Nelle attività di retrieval richiede una particolare attenzione: le domande devono essere precedute dal prefisso query:, mentre i testi indicizzati devono iniziare con passage:. Questi prefissi vengono utilizzati anche quando il contenuto è scritto in italiano. Ometterli non produce un errore, ma può peggiorare la qualità della ricerca. Il modello accetta inoltre testi fino a 512 token, un limite da considerare quando si utilizzano chunk più lunghi.
BGE-M3 si distingue soprattutto per la sua versatilità. Può produrre un singolo vettore denso, una rappresentazione sparsa basata sui termini presenti nel testo e una rappresentazione multi-vettore simile a quella utilizzata da ColBERT. Supporta testi fino a 8.192 token e può quindi essere impiegato anche in sistemi di ricerca ibrida. Le diverse rappresentazioni non vengono però combinate automaticamente: devono essere richieste e gestite dalla pipeline che utilizza il modello.
Tra le alternative più leggere c’è gte-multilingual-base, che ha circa 305 milioni di parametri, supporta testi fino a 8.192 token e può generare rappresentazioni dense e sparse. Permette inoltre di ridurre la dimensione dei vettori, sacrificando eventualmente una parte dell’accuratezza in cambio di un indice più piccolo e di ricerche meno costose.
EmbeddingGemma-300M è stato progettato per funzionare anche su dispositivi con risorse limitate. Ha 300 milioni di parametri, accetta testi fino a 2.048 token e produce vettori di 768 dimensioni, riducibili a 512, 256 o 128. Può quindi rappresentare una scelta interessante per applicazioni locali su portatili e computer senza una GPU particolarmente potente.
L’alternativa ai modelli eseguiti localmente è utilizzare un servizio esterno. Questa soluzione evita di gestire direttamente l’hardware e semplifica la scalabilità, ma introduce costi legati al numero di testi elaborati e richiede di trasmettere i documenti al fornitore. La scelta dipende quindi anche dalla riservatezza dei contenuti e dal volume dell’archivio.
I benchmark come MTEB sono utili per restringere il numero delle alternative, ma i loro punteggi aggregano lingue, raccolte e compiti differenti. Un modello che ottiene una media più alta non è necessariamente quello che recupera meglio le informazioni da uno specifico corpus italiano.
5. Cos’è il pooling negli embedding
Il pooling è l’operazione con cui un modello di embedding riunisce le rappresentazioni dei singoli token in un unico vettore che rappresenta l’intero testo.
Quando un chunk viene elaborato da un embedder, il modello calcola inizialmente un vettore per ciascun token, tenendo conto del contesto in cui compare. In questa fase esistono quindi tanti vettori quanti sono i token. Il pooling li combina, o ne seleziona uno particolare, per ottenere il singolo vettore associato al chunk.
I metodi più comuni sono il mean pooling, il CLS pooling e il last-token pooling.
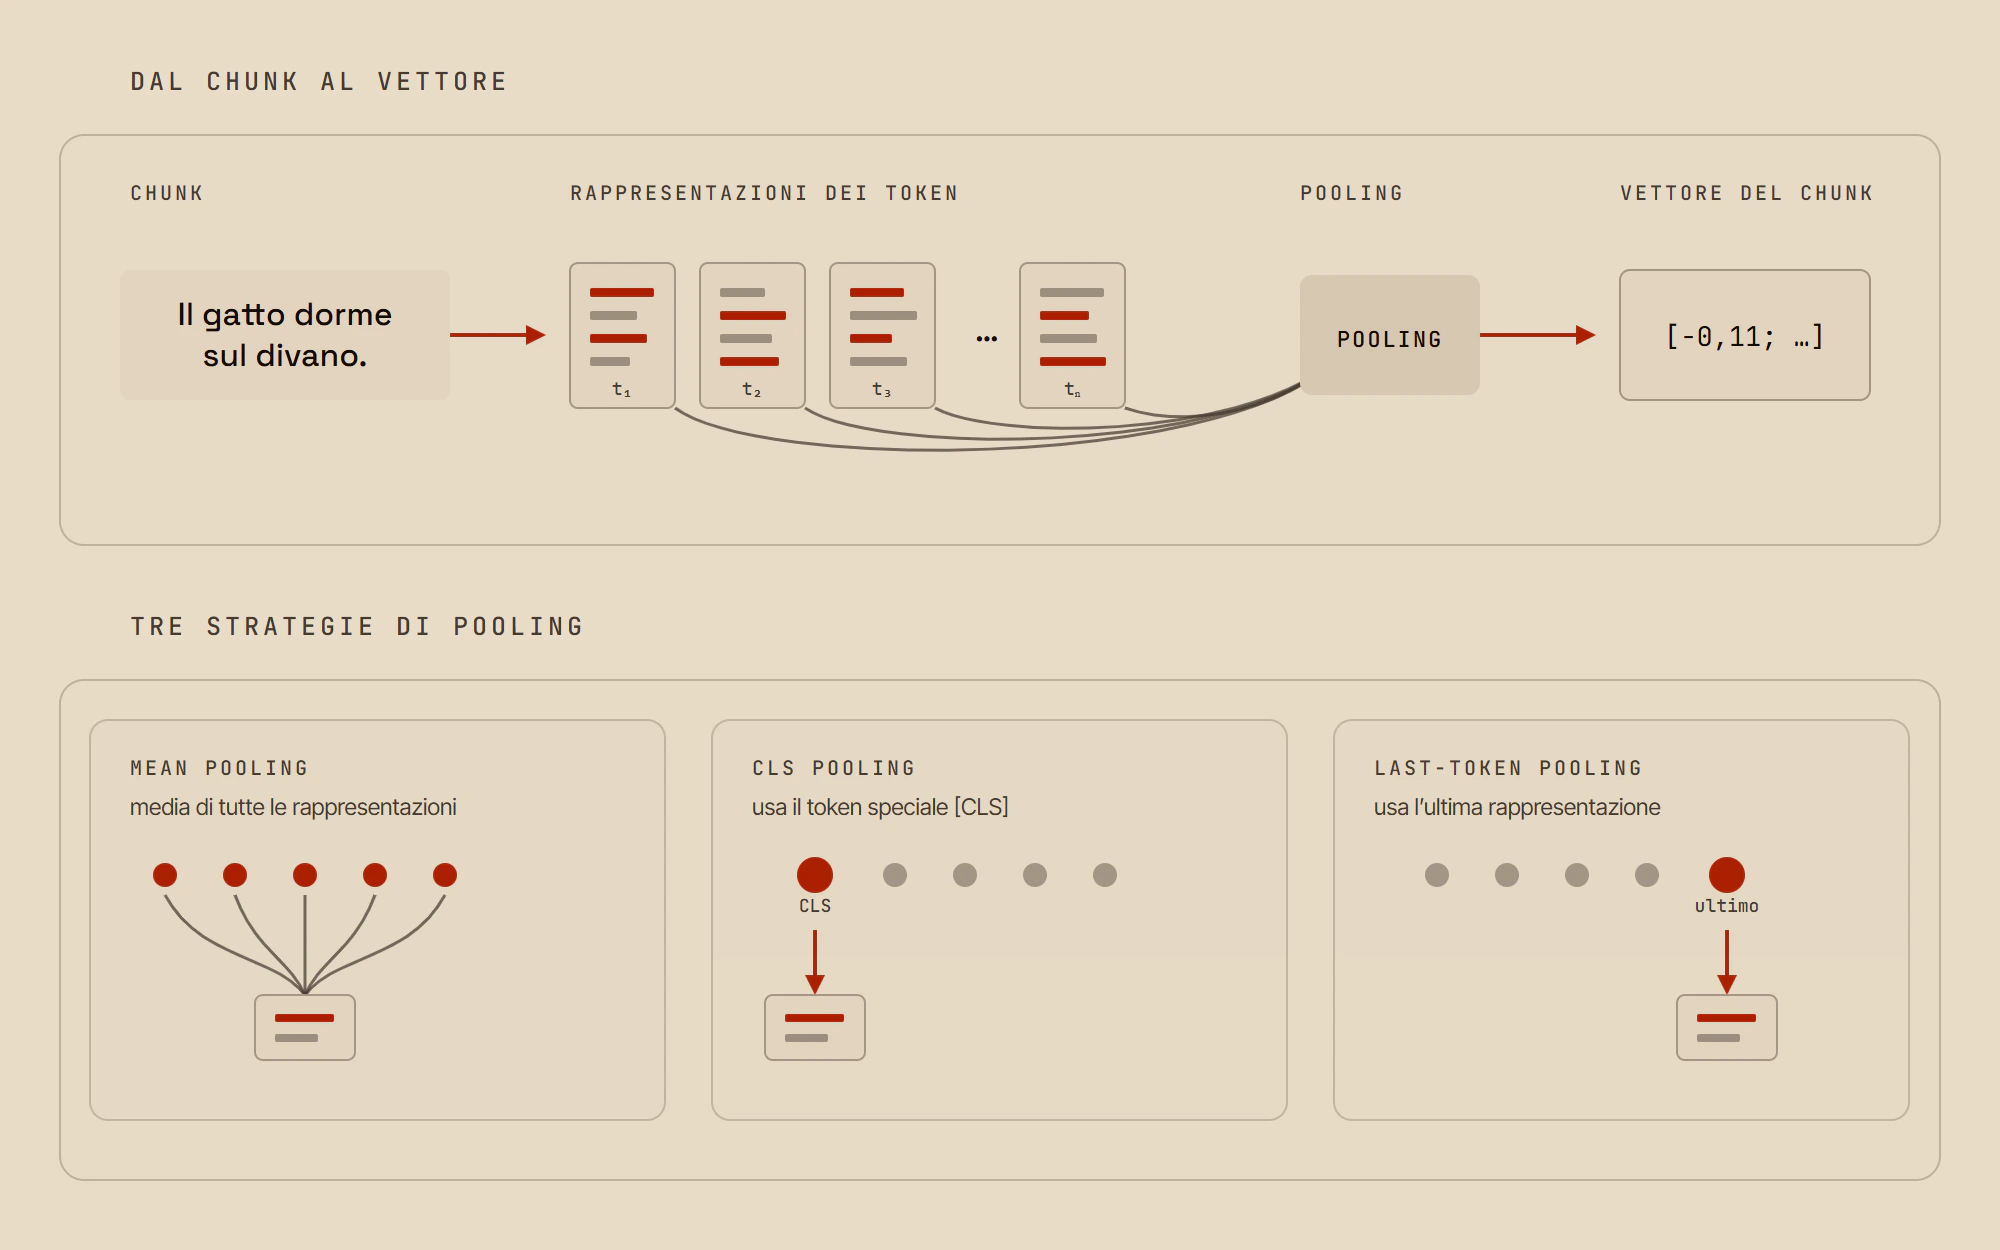
Il mean pooling calcola la media dei vettori associati ai token, escludendo normalmente quelli aggiunti soltanto per completare la sequenza. In questo modo ogni parte del testo contribuisce alla rappresentazione complessiva del chunk.
Il CLS pooling utilizza invece la rappresentazione di un token speciale, generalmente inserito all’inizio del testo. Durante l’elaborazione questo token interagisce con gli altri e raccoglie informazioni sull’intera sequenza. Il suo vettore viene quindi utilizzato come rappresentazione del chunk.
Il last-token pooling seleziona la rappresentazione dell’ultimo token valido della sequenza. Non si tratta della somma dei vettori precedenti: nei modelli che elaborano il testo da sinistra a destra, l’ultima posizione può tenere conto di tutti i token che la precedono attraverso i meccanismi di attenzione. Questo metodo funziona quando il modello è stato addestrato affinché l’ultima posizione rappresenti efficacemente l’intero testo.
Il metodo di pooling non viene normalmente scelto dall’utente, perché dipende dal modo in cui è stato addestrato il modello e le librerie più comuni lo applicano automaticamente. È però necessario verificarlo quando si utilizza direttamente il modello, si costruisce una pipeline personalizzata oppure si adopera una versione convertita o quantizzata.
Per esempio:
- multilingual-e5-large utilizza il mean pooling
- BGE-M3 e gte-multilingual-base utilizzano la rappresentazione del primo token, corrispondente al CLS pooling
- la famiglia Qwen3-Embedding utilizza il last-token pooling.
La documentazione e il codice ufficiale del modello specificano quale pooling utilizzare. Una configurazione diversa può continuare a produrre vettori della dimensione prevista e nascondere così il problema, mentre la qualità della rappresentazione e del retrieval può peggiorare sensibilmente.
Il pooling aiuta anche a comprendere il late chunking, che vedremo nel prossimo paragrafo. Questa tecnica conserva temporaneamente le rappresentazioni dei singoli token e applica il pooling soltanto dopo aver individuato le porzioni corrispondenti ai chunk. Proprio per questo non può essere applicata indistintamente a qualsiasi modello.
5.1. Cos’è il late chunking
Il late chunking è una tecnica che permette di creare embedding dei chunk conservando parte del contesto del documento completo. A differenza del chunking tradizionale, il testo viene diviso soltanto dopo essere stato elaborato dal modello di embedding.
Nel procedimento tradizionale, ogni chunk viene passato separatamente all’embedder. Il modello conosce quindi soltanto le parole contenute in quella porzione di testo e non può utilizzare le informazioni presenti nei chunk precedenti o successivi.
Con il late chunking, invece, il documento viene elaborato come un’unica sequenza, purché non superi la finestra di contesto del modello. L’embedder calcola una rappresentazione per ciascun token tenendo conto del testo circostante. Soltanto dopo vengono individuati i token appartenenti ai diversi chunk e viene applicato il mean pooling separatamente a ciascun gruppo. Il risultato è ancora un vettore per ogni chunk, ma costruito a partire da rappresentazioni che hanno potuto utilizzare un contesto più ampio.
La tecnica è stata presentata nel 2024 da un gruppo di ricercatori di Jina AI. L’esempio utilizzato dagli autori riguarda un testo su Berlino. Alcune frasi si riferiscono alla città con espressioni come «i suoi abitanti» o «la città», senza ripeterne il nome. Se queste frasi vengono elaborate separatamente, la loro relazione con Berlino può risultare debole. Con il late chunking, invece, i token sono stati contestualizzati insieme al passaggio nel quale compare il nome della città e il collegamento può essere conservato nell’embedding del chunk.
Il late chunking non elimina quindi la suddivisione del documento: ne rimanda l’applicazione. I confini dei chunk devono comunque essere stabiliti, ma vengono utilizzati dopo che il modello ha elaborato il testo completo.
Questa tecnica presenta anche alcuni limiti. Il modello deve supportare sequenze abbastanza lunghe, permettere l’accesso alle rappresentazioni dei singoli token ed essere compatibile con il pooling applicato alle porzioni della sequenza. Nella formulazione originale, i vettori dei chunk vengono ottenuti mediante mean pooling. Non è quindi sufficiente applicare automaticamente il procedimento a qualsiasi embedder, soprattutto se il modello è stato addestrato per utilizzare un altro metodo di pooling.
Anche il consumo di memoria e il tempo di elaborazione aumentano con la lunghezza del documento. Se il testo supera la finestra di contesto, deve comunque essere suddiviso in porzioni più ampie prima dell’elaborazione. Il late chunking non è dunque una soluzione universale, ma può ridurre la perdita di contesto quando i chunk contengono riferimenti comprensibili soltanto alla luce delle parti circostanti.
6. Come si confrontano gli embedding
Per recuperare i contenuti pertinenti, un sistema RAG confronta l’embedding della domanda con quelli dei chunk indicizzati. Più due vettori risultano vicini secondo la misura utilizzata, maggiore sarà la somiglianza attribuita ai testi che rappresentano.
La misura più comune è la similarità del coseno, che confronta la direzione dei vettori attraverso l’angolo formato tra loro. Se puntano in direzioni simili, il valore si avvicina a 1; se sono perpendicolari, è pari a 0; se puntano in direzioni opposte, può avvicinarsi a -1. La lunghezza dei vettori non influisce sul risultato.
Un’alternativa è il prodotto scalare, che tiene conto sia della direzione sia della lunghezza dei vettori. La distanza euclidea misura invece la distanza in linea retta tra i due punti nello spazio vettoriale. In questo caso, valori più bassi indicano una maggiore vicinanza.
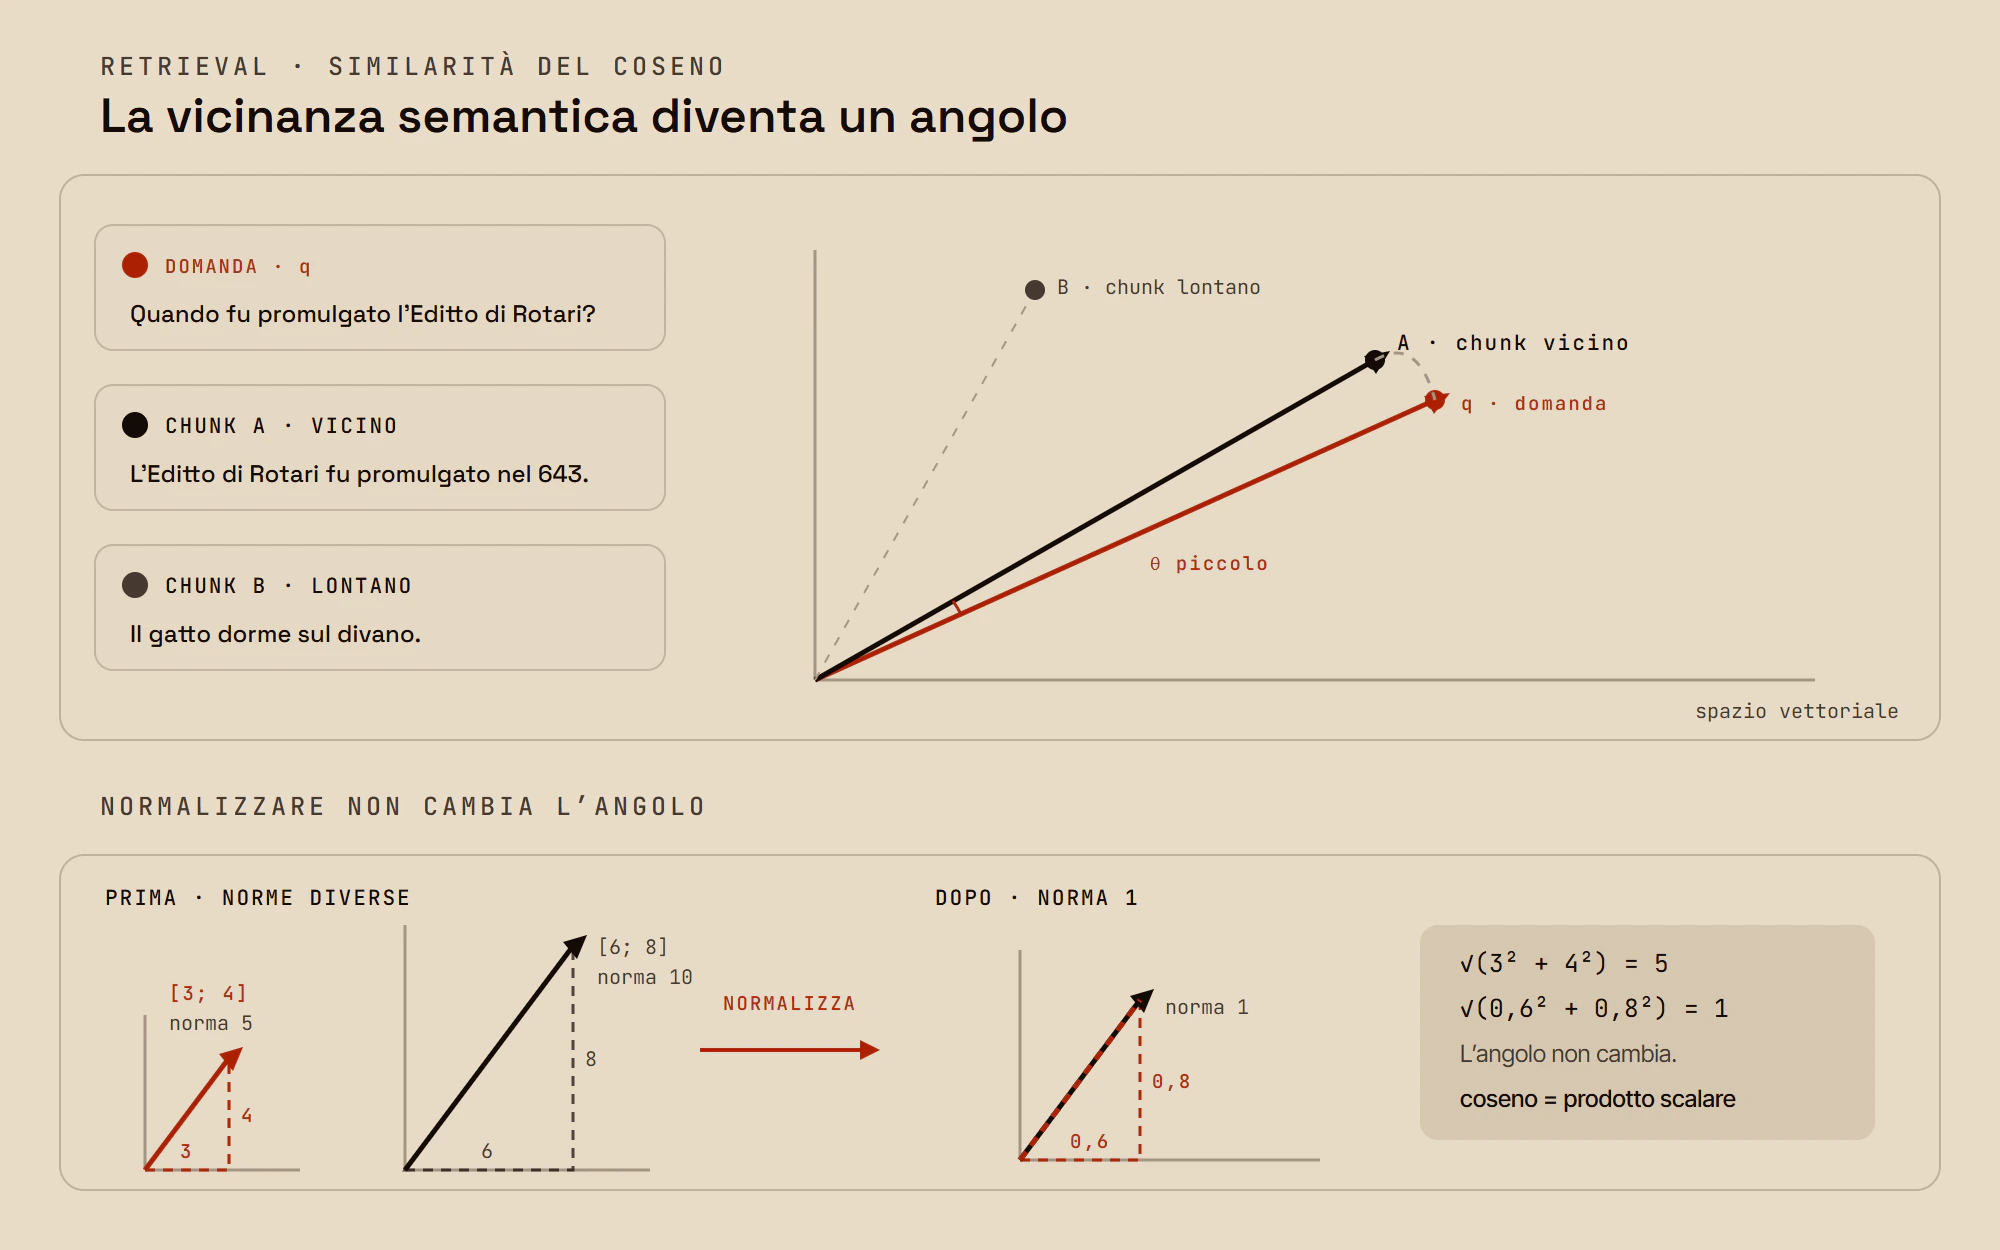
Per comprendere il rapporto tra queste misure bisogna sapere che ogni vettore possiede anche una norma, cioè una lunghezza geometrica. Normalizzare un vettore significa ridimensionarne i valori in modo che la sua norma diventi pari a 1, senza modificarne la direzione.
La normalizzazione è utile quando si vuole confrontare soltanto la direzione dei vettori, evitando che la loro lunghezza influenzi il risultato. Inoltre, con vettori normalizzati, il prodotto scalare restituisce lo stesso valore della similarità del coseno e anche la distanza euclidea produce lo stesso ordinamento, ma in senso inverso.
Questo non significa che tutti i sistemi debbano normalizzare esplicitamente gli embedding. Alcuni modelli producono già vettori normalizzati, alcune librerie eseguono automaticamente l’operazione e la similarità del coseno può essere calcolata anche su vettori non normalizzati. In altri casi, invece, la lunghezza del vettore può far parte della rappresentazione appresa dal modello e non deve essere eliminata arbitrariamente.
La misura corretta viene normalmente indicata nella documentazione del modello. Utilizzarne una diversa, soprattutto quando gli embedding non sono normalizzati, può modificare l’ordine dei risultati e peggiorare la qualità del retrieval.
Il punteggio ottenuto non rappresenta la probabilità che un chunk contenga la risposta. Indica soltanto quanto il suo embedding risulta vicino a quello della domanda nello spazio costruito dal modello. I punteggi prodotti da modelli differenti non sono direttamente confrontabili. Per esempio, una soglia di 0,8 può essere molto selettiva per un modello e permissiva per un altro.
7. Cos’è un database vettoriale
Un database vettoriale è un sistema progettato per conservare, indicizzare e confrontare gli embedding. In una pipeline RAG associa ogni vettore al chunk dal quale è stato generato e agli eventuali metadati, come il titolo del documento, l’autore, la sezione o la data.
Quando arriva una domanda, il sistema ne calcola l’embedding e cerca nel database i vettori più vicini. Dai risultati risale quindi ai chunk corrispondenti, che possono essere utilizzati per costruire il contesto da fornire al modello generativo.
I database vettoriali non si distinguono soltanto per gli algoritmi di ricerca, ma anche per il modo in cui vengono eseguiti. LanceDB e Chroma, per esempio, possono funzionare direttamente all’interno dell’applicazione e salvare i dati sul disco senza richiedere l’avvio di un servizio separato. Questa modalità è particolarmente comoda per progetti personali, prototipi e archivi di dimensioni contenute.
Qdrant e Weaviate vengono spesso eseguiti come servizi autonomi, installati localmente, su un server oppure utilizzati attraverso un servizio cloud. Entrambi dispongono anche di modalità incorporate o semplificate, utili soprattutto durante lo sviluppo.
Un’altra possibilità è pgvector, un’estensione di PostgreSQL che permette di conservare e cercare gli embedding all’interno di un database relazionale. Può essere una scelta conveniente quando l’applicazione utilizza già PostgreSQL e deve combinare la ricerca vettoriale con dati strutturati e filtri tradizionali.
Non tutti i sistemi RAG hanno quindi bisogno di un database vettoriale dedicato. Per un archivio piccolo può essere sufficiente confrontare direttamente tutti i vettori, mentre in altri casi può essere preferibile aggiungere la ricerca vettoriale a un database già esistente. La scelta dipende soprattutto dal numero di vettori, dalla velocità richiesta, dai filtri necessari e dal modo in cui l’applicazione verrà distribuita.
In questo ambito si incontrano spesso anche nomi come LangChain e LlamaIndex, ma non si tratta di database vettoriali. Sono framework che offrono componenti e integrazioni per costruire una pipeline RAG. Possono leggere i documenti, dividerli in chunk, richiamare il modello di embedding e inserire i risultati nel database scelto. Non sono però indispensabili, perché le stesse operazioni possono essere eseguite direttamente mediante il modello di embedding e il client del database.
7.1. Come funziona un indice vettoriale
Un indice vettoriale è una struttura che organizza gli embedding in modo da trovare rapidamente quelli più vicini al vettore della domanda.
Il metodo più semplice consiste nel confrontare il vettore della domanda con tutti quelli conservati nel database, uno alla volta. Questa ricerca restituisce i vicini esatti, ma il numero dei confronti cresce insieme alle dimensioni dell’archivio. Con qualche migliaio di chunk il costo può essere trascurabile, mentre con milioni di vettori la ricerca può diventare troppo lenta.
Per questo i database vettoriali utilizzano spesso algoritmi di ricerca approssimata, indicati con la sigla ANN, Approximate Nearest Neighbor. Questi algoritmi accelerano la ricerca evitando di esaminare l’intero archivio.
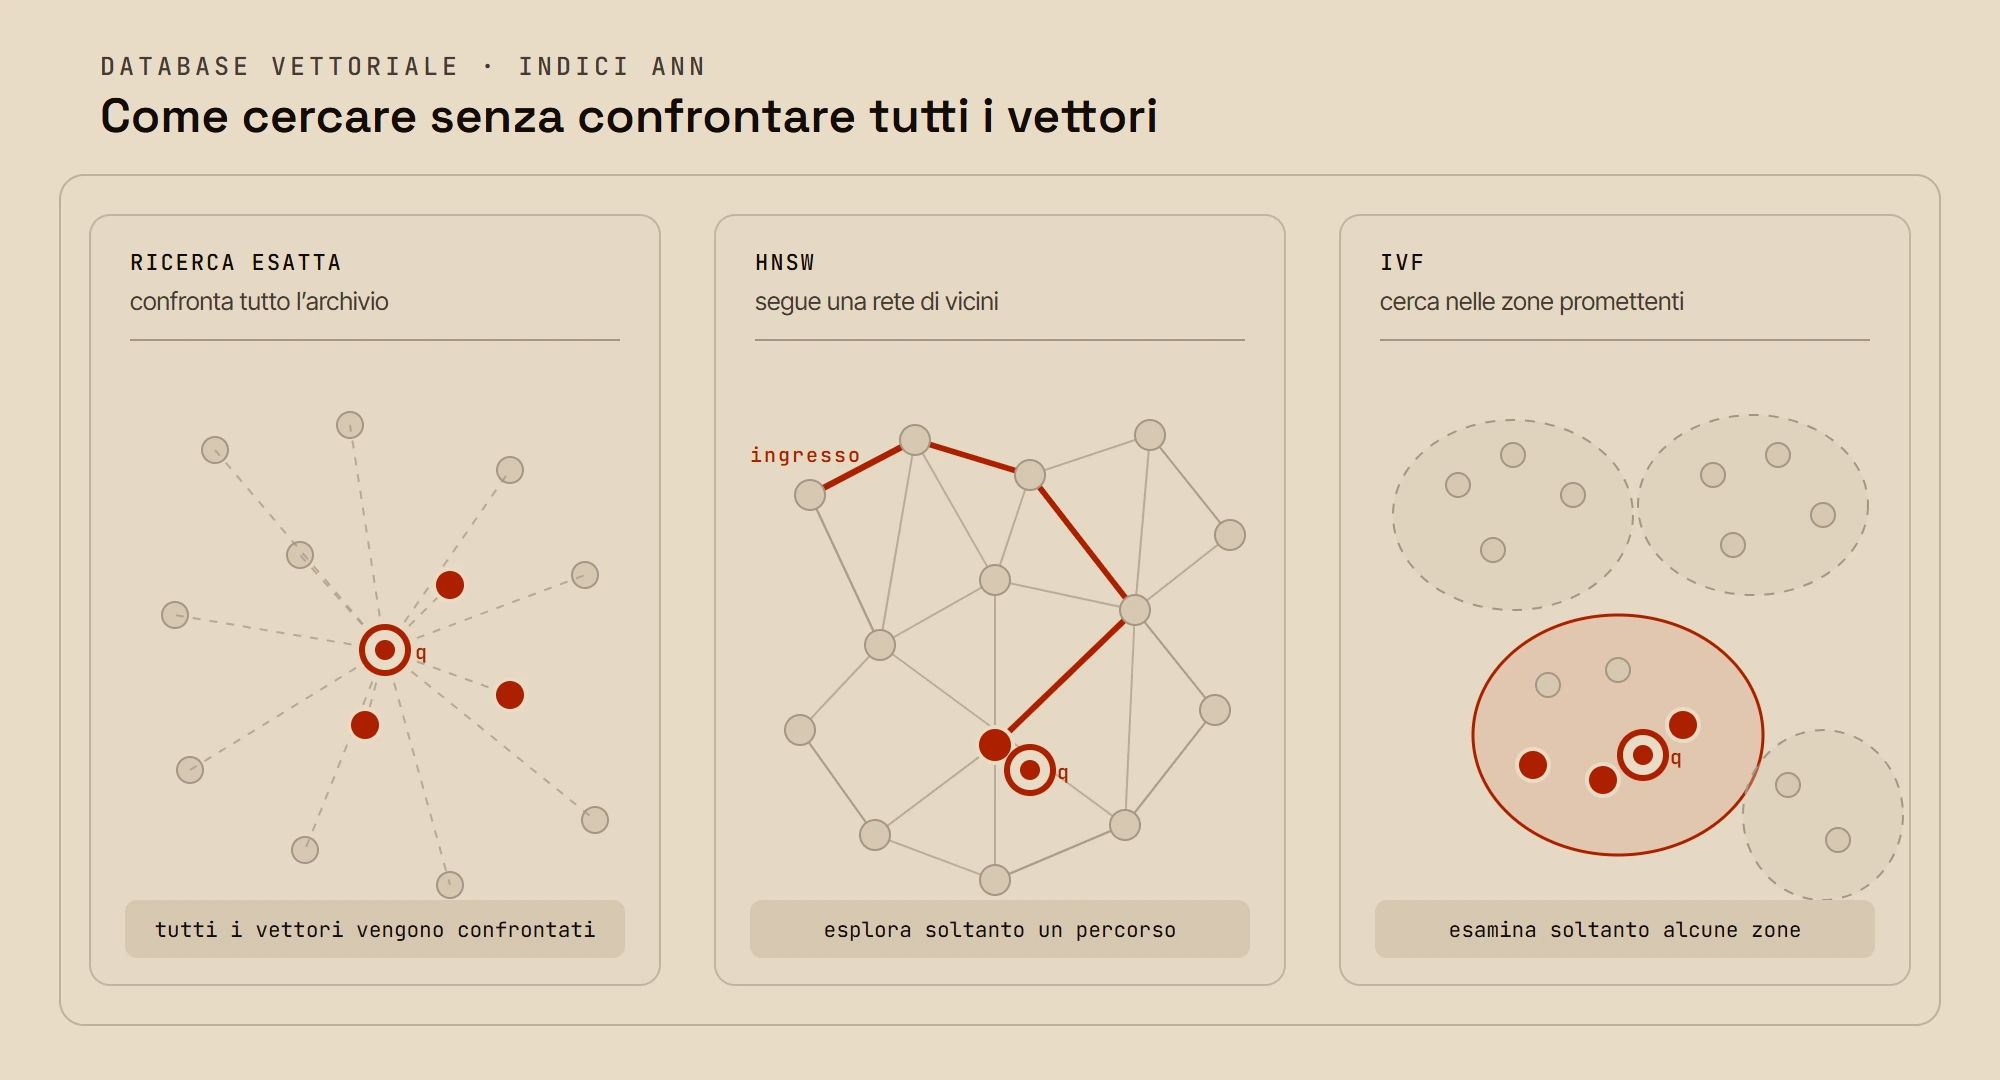
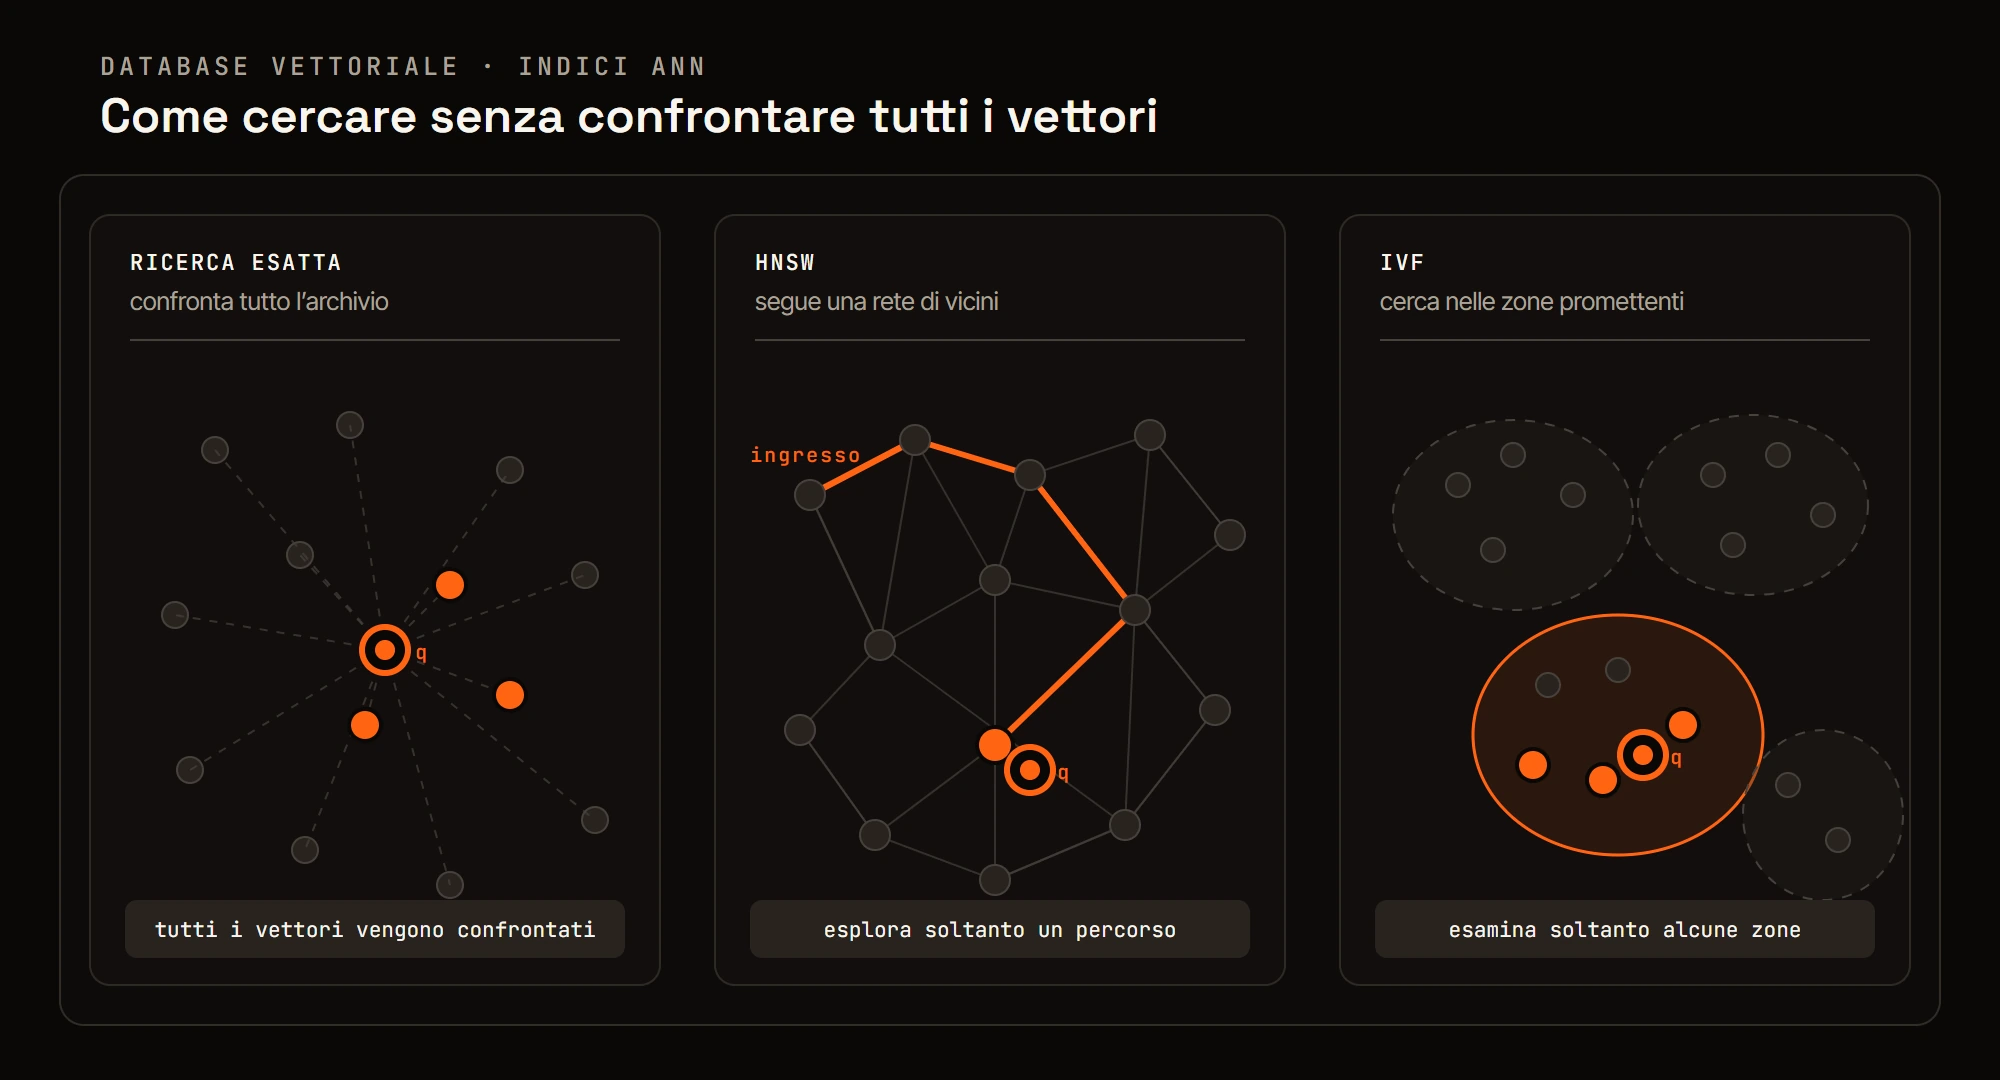
Uno degli indici più diffusi è HNSW, Hierarchical Navigable Small World. L’algoritmo costruisce una rete di collegamenti tra i vettori, organizzata su più livelli. I livelli superiori contengono meno vettori e permettono di attraversare rapidamente grandi porzioni dello spazio. La ricerca scende progressivamente verso i livelli inferiori, seguendo i collegamenti che sembrano condurre ai risultati più vicini.
Un altro approccio è IVF, Inverted File Index. In questo caso i vettori vengono raggruppati preventivamente in diverse zone. Quando arriva una domanda, il sistema individua quelle più vicine al suo embedding e limita il confronto ai vettori contenuti al loro interno.
Il termine “approssimata” va preso alla lettera. Questi indici aumentano notevolmente la velocità, ma non garantiscono di restituire sempre i vettori effettivamente più vicini. Un chunk pertinente può essere escluso perché il percorso seguito da HNSW non lo ha raggiunto oppure perché si trova in una zona che IVF non ha esaminato.
Le implementazioni permettono generalmente di regolare il compromesso tra velocità e accuratezza stabilendo quanti collegamenti, zone o candidati devono essere esplorati. Esplorarne un numero maggiore aumenta la probabilità di trovare i vicini corretti, ma rallenta la ricerca.
Accanto agli indici può essere utilizzata anche la quantizzazione, che rappresenta i valori dei vettori con una precisione inferiore. In questo modo diminuiscono lo spazio occupato e la quantità di calcoli necessari, accettando una possibile perdita di accuratezza. Non si tratta di un algoritmo di ricerca come HNSW o IVF, ma di una tecnica complementare per ridurre i costi.
L’indice vettoriale costituisce quindi un altro punto del retrieval nel quale l’informazione giusta può andare perduta silenziosamente. Se un chunk pertinente non viene recuperato, la causa non è necessariamente il modello di embedding. Può essere l’indice che non lo ha raggiunto.
8. Cos’è il retrieval nella RAG
Il retrieval è la fase della RAG in cui il sistema cerca nei documenti indicizzati le informazioni più pertinenti rispetto alla domanda dell’utente.
Il componente che esegue questa ricerca prende il nome di retriever. Il suo compito non è formulare la risposta, ma individuare i chunk potenzialmente utili e ordinarli in base alla loro pertinenza.
Nel caso della ricerca vettoriale, anche la domanda viene trasformata in un embedding. Il retriever confronta questo vettore con quelli conservati nell’indice e assegna ai chunk un ordine basato sulla loro vicinanza. Come vedremo, il retrieval può essere eseguito anche attraverso le parole presenti nei testi oppure combinando più metodi di ricerca.
Il numero dei risultati che il retriever lascia proseguire è indicato come top-k. Questo valore viene stabilito durante la configurazione del sistema.
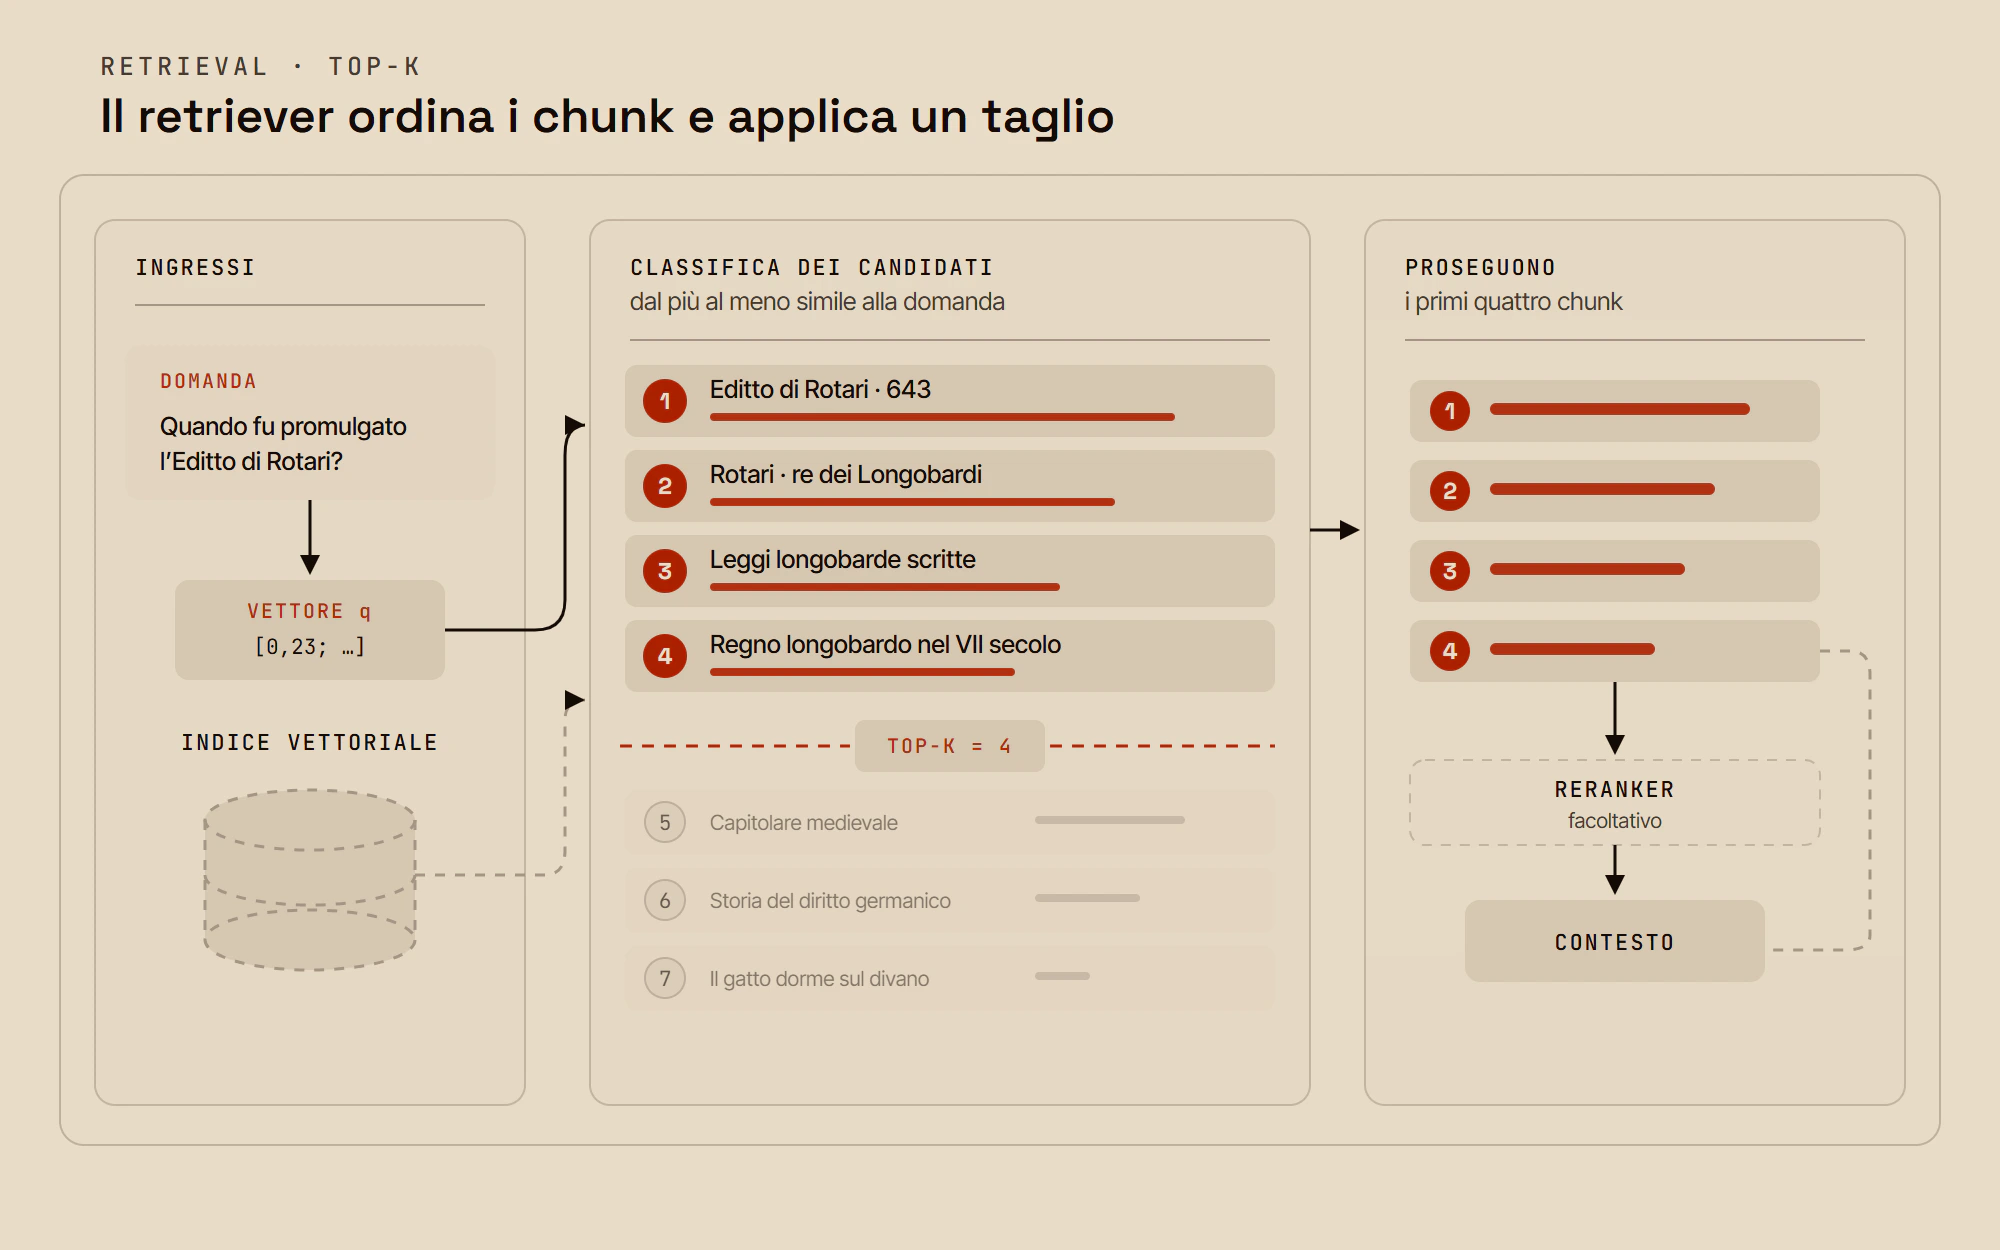
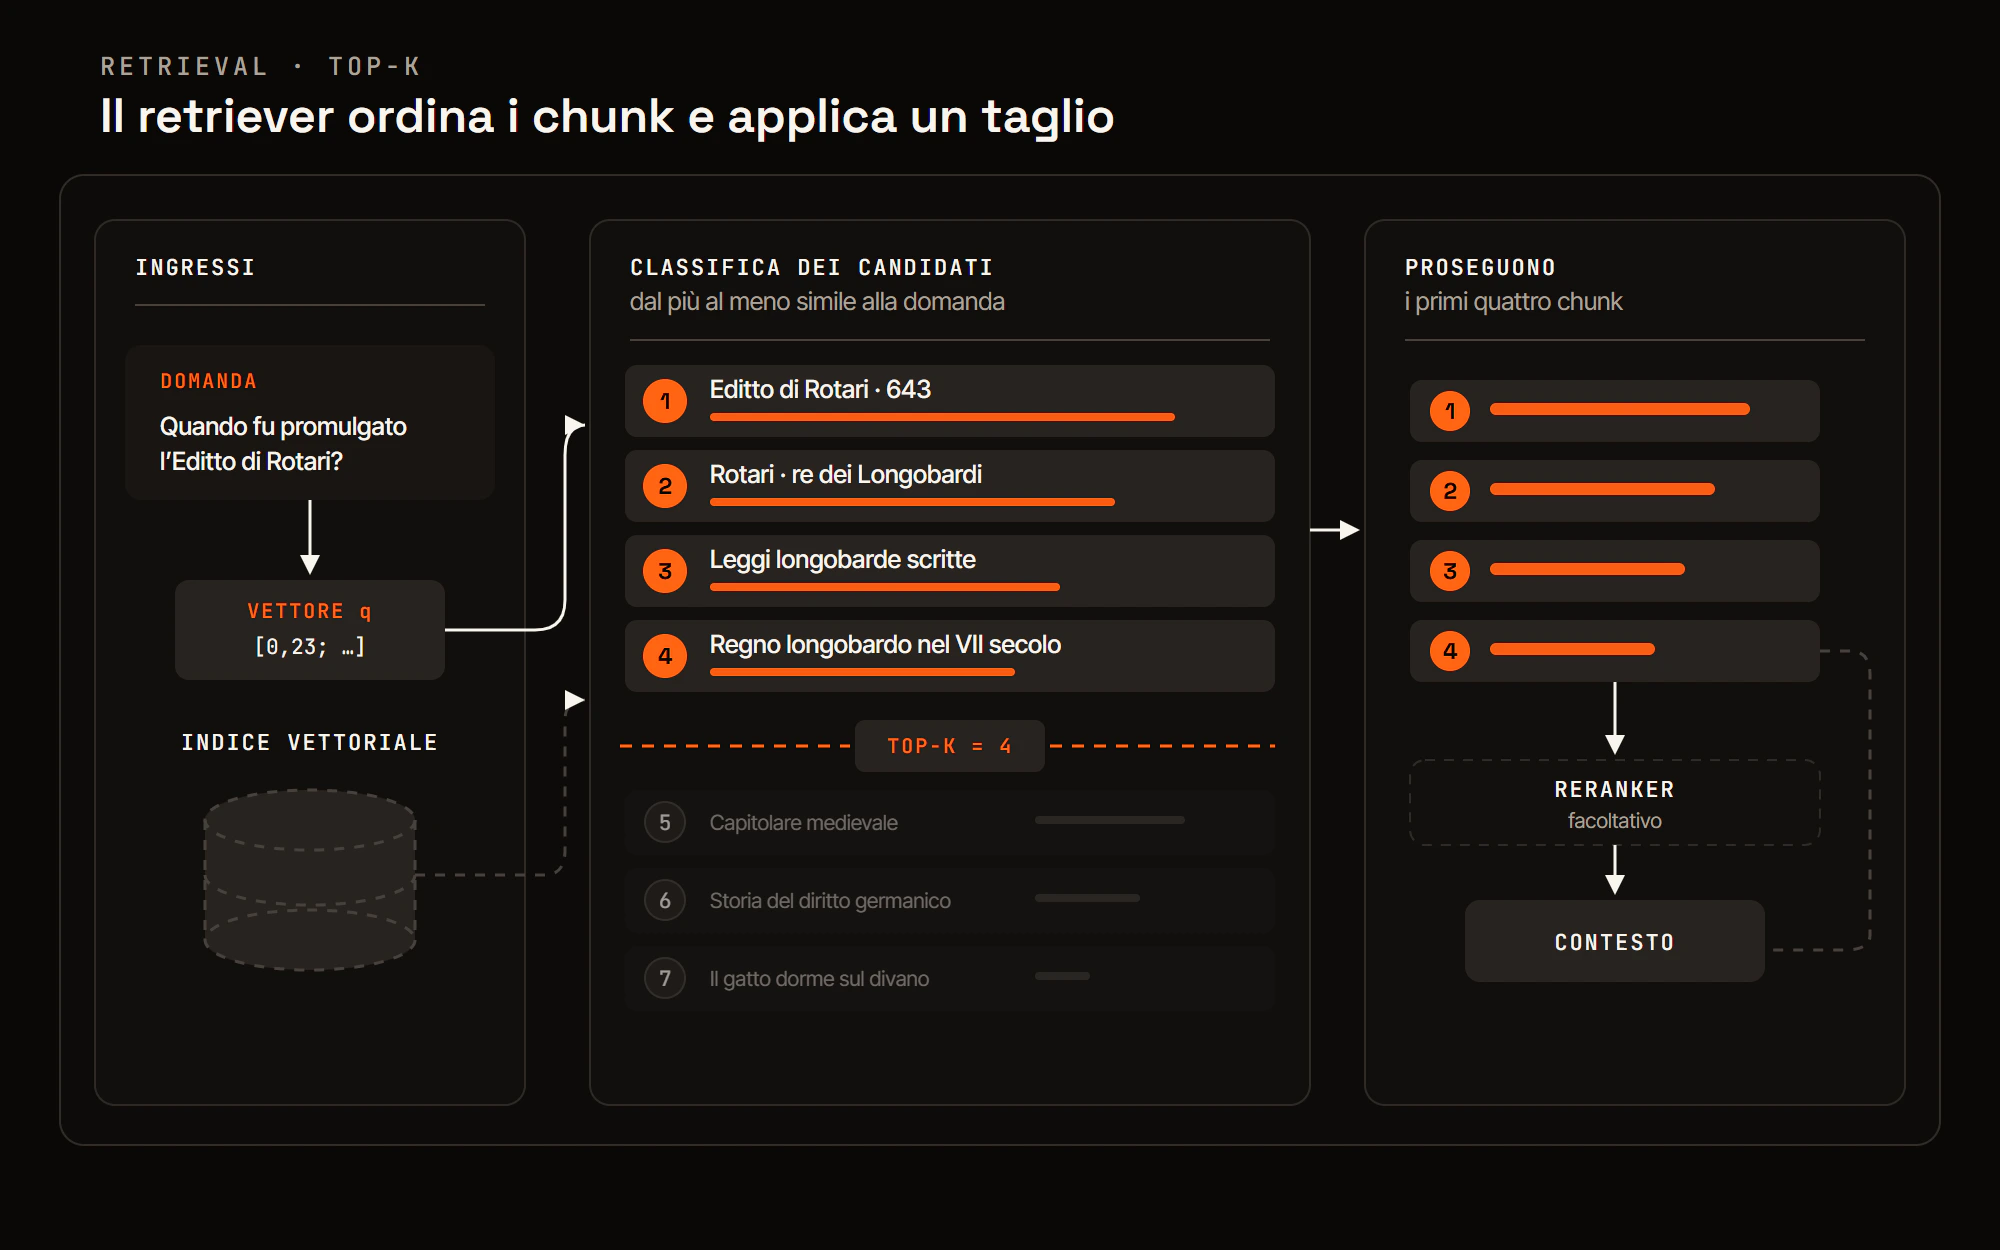
Un valore troppo basso può escludere un passaggio utile, mentre uno troppo alto può introdurre risultati irrilevanti o fuorvianti. Poiché il modello generativo può utilizzare soltanto i chunk selezionati, in entrambi i casi rischia di produrre una risposta convincente ma basata su informazioni incomplete o non pertinenti.
9. BM25, ricerca semantica e ricerca ibrida
Il retrieval può cercare i chunk utilizzando le parole presenti nei testi, il significato rappresentato dagli embedding oppure una combinazione dei due metodi.
I principali approcci sono
- la ricerca full-text o lessicale
- la ricerca semantica
- la ricerca ibrida
9.1. Cos’è BM25
BM25 è una funzione utilizzata per ordinare i risultati di una ricerca full-text in base alla loro probabile pertinenza rispetto alle parole cercate.
La ricerca full-text costruisce un indice dei termini presenti nei documenti. Quando arriva una domanda, il sistema consulta questo indice per trovare i chunk che contengono le parole della ricerca. Se gli stessi termini compaiono in molti testi, BM25 stabilisce quali risultati mostrare per primi.
Il nome deriva da Best Match e dal numero assegnato alla funzione durante gli esperimenti condotti con il sistema di ricerca Okapi. Il valore 25 non è quindi un parametro da configurare.
BM25 assegna un punteggio a ogni chunk considerando soprattutto la frequenza dei termini cercati, la loro rarità nell’intera raccolta e la lunghezza del testo. Una parola rara tende ad avere più peso di una molto comune. Anche la ripetizione aumenta il punteggio, ma il suo effetto diminuisce progressivamente. Scrivere “Rotari” venti volte non rende automaticamente un testo venti volte più pertinente.
Immaginiamo di cercare «Editto di Rotari 643» in una raccolta contenente tre chunk.
- «L’Editto di Rotari fu promulgato nel 643»
- «Rotari fu re dei Longobardi e promulgò un importante editto»
- Un lungo testo sui sovrani longobardi nel quale il nome Rotari compare una sola volta.
BM25 collocherebbe probabilmente al primo posto il primo chunk, perché contiene insieme i termini più importanti in un testo breve. Il secondo seguirebbe perché contiene “Rotari” ed “editto”, ma non la data. Il terzo riceverebbe un punteggio più basso perché contiene soltanto “Rotari” all’interno di un testo molto più lungo.
BM25 è particolarmente efficace con nomi propri, date, sigle, citazioni e termini tecnici. Il suo limite ovviamente è la dipendenza dalle parole effettivamente presenti nei documenti.
9.2. La ricerca semantica
La ricerca semantica confronta l’embedding della domanda con quelli dei chunk indicizzati. Può quindi recuperare un testo pertinente anche quando non contiene esattamente le stesse parole utilizzate dall’utente.
Questo metodo riesce a riconoscere parafrasi ed espressioni simili che potrebbero sfuggire a BM25. Può però essere meno preciso con nomi propri, date, sigle o concetti molto vicini tra loro. Due sovrani della stessa epoca potrebbero occupare posizioni simili nello spazio vettoriale anche se la domanda riguarda soltanto uno dei due.
La ricerca vettoriale tende inoltre a produrre sempre una classifica. Anche quando nessun chunk è realmente pertinente, il sistema può comunque restituire quelli che risultano meno lontani dalla domanda.
9.3. La ricerca ibrida
La ricerca ibrida combina i risultati della ricerca lessicale con quelli della ricerca semantica. In questo modo può sfruttare la precisione di BM25 sulle parole esatte e la capacità degli embedding di riconoscere significati simili.
I punteggi prodotti dai due sistemi non sono direttamente confrontabili e non conviene sommarli senza prima normalizzarli o calibrarli. Per combinarli si può utilizzare il Reciprocal Rank Fusion, generalmente abbreviato in RRF.
RRF considera la posizione occupata da ciascun chunk nelle due classifiche. Un risultato presente ai primi posti in entrambe riceve il contributo di tutte e due, mentre un risultato trovato da un solo metodo riceve soltanto il contributo di quella classifica.
La ricerca ibrida rappresenta spesso un buon punto di partenza, ma non è sempre necessaria. Se occorre trovare una citazione precisa, un nome o una data, la ricerca full-text può essere sufficiente. Quando invece la domanda può essere formulata in modi molto diversi, la componente semantica diventa più utile. La scelta deve quindi essere verificata sui documenti e sulle domande reali del progetto.
10. Cos’è un reranker e come funziona
Un reranker è un modello che rivaluta i risultati prodotti dal retriever e li riordina in base alla loro pertinenza rispetto alla domanda.
Il reranker riceve contemporaneamente la domanda e uno dei chunk recuperati. Può quindi confrontare direttamente i due testi e assegnare un nuovo punteggio di pertinenza. L’operazione viene ripetuta per tutti i candidati e produce una seconda classifica.
Questa valutazione richiede più calcoli e non viene applicata all’intero archivio. Il retriever recupera rapidamente un primo gruppo di candidati, per esempio venti o trenta, mentre il reranker li esamina, li riordina e ne conserva soltanto alcuni. Il sistema combina così una prima ricerca veloce con una valutazione più approfondita su un insieme molto più piccolo.
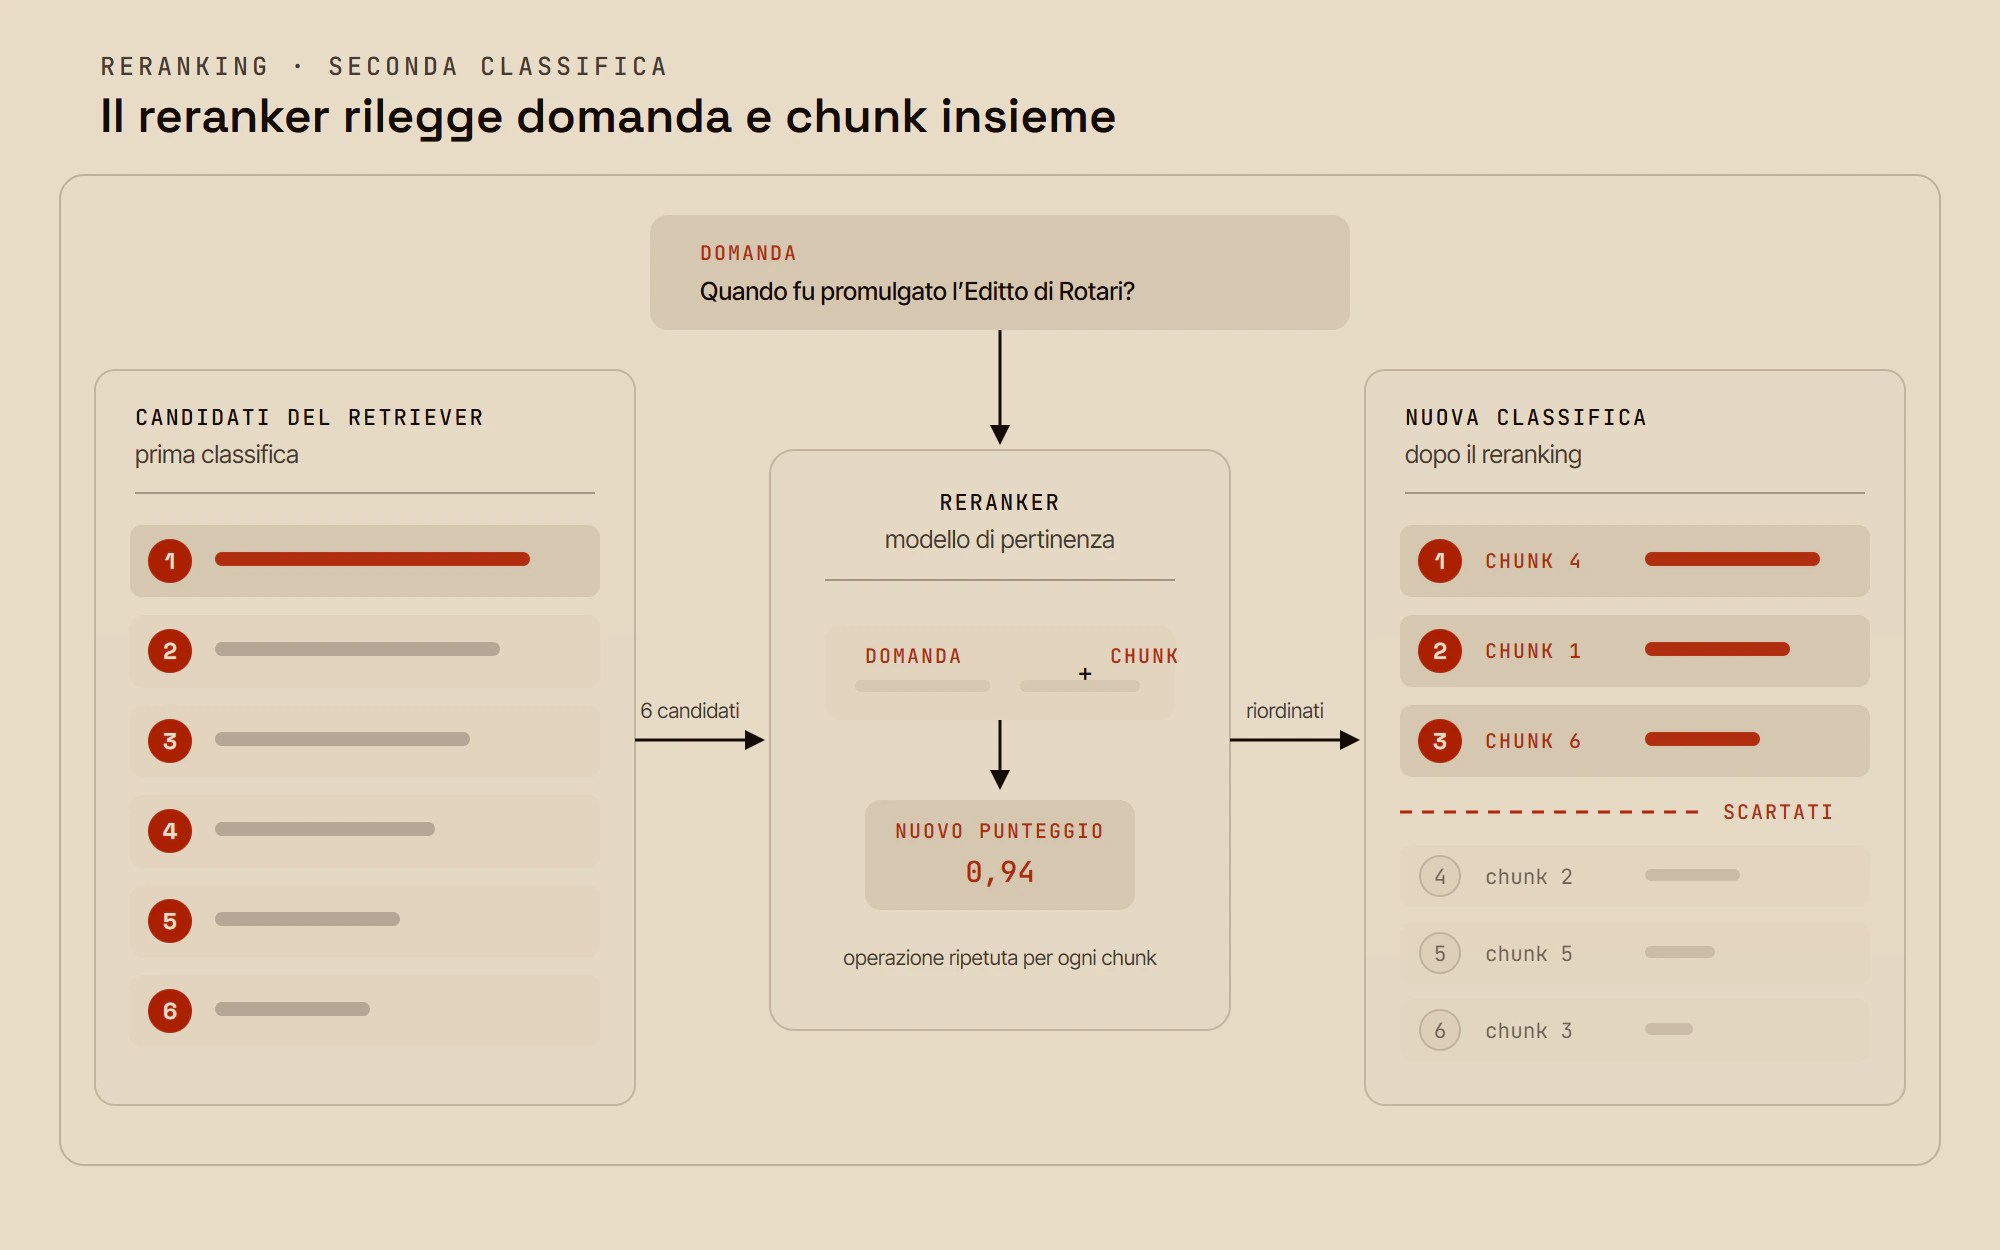
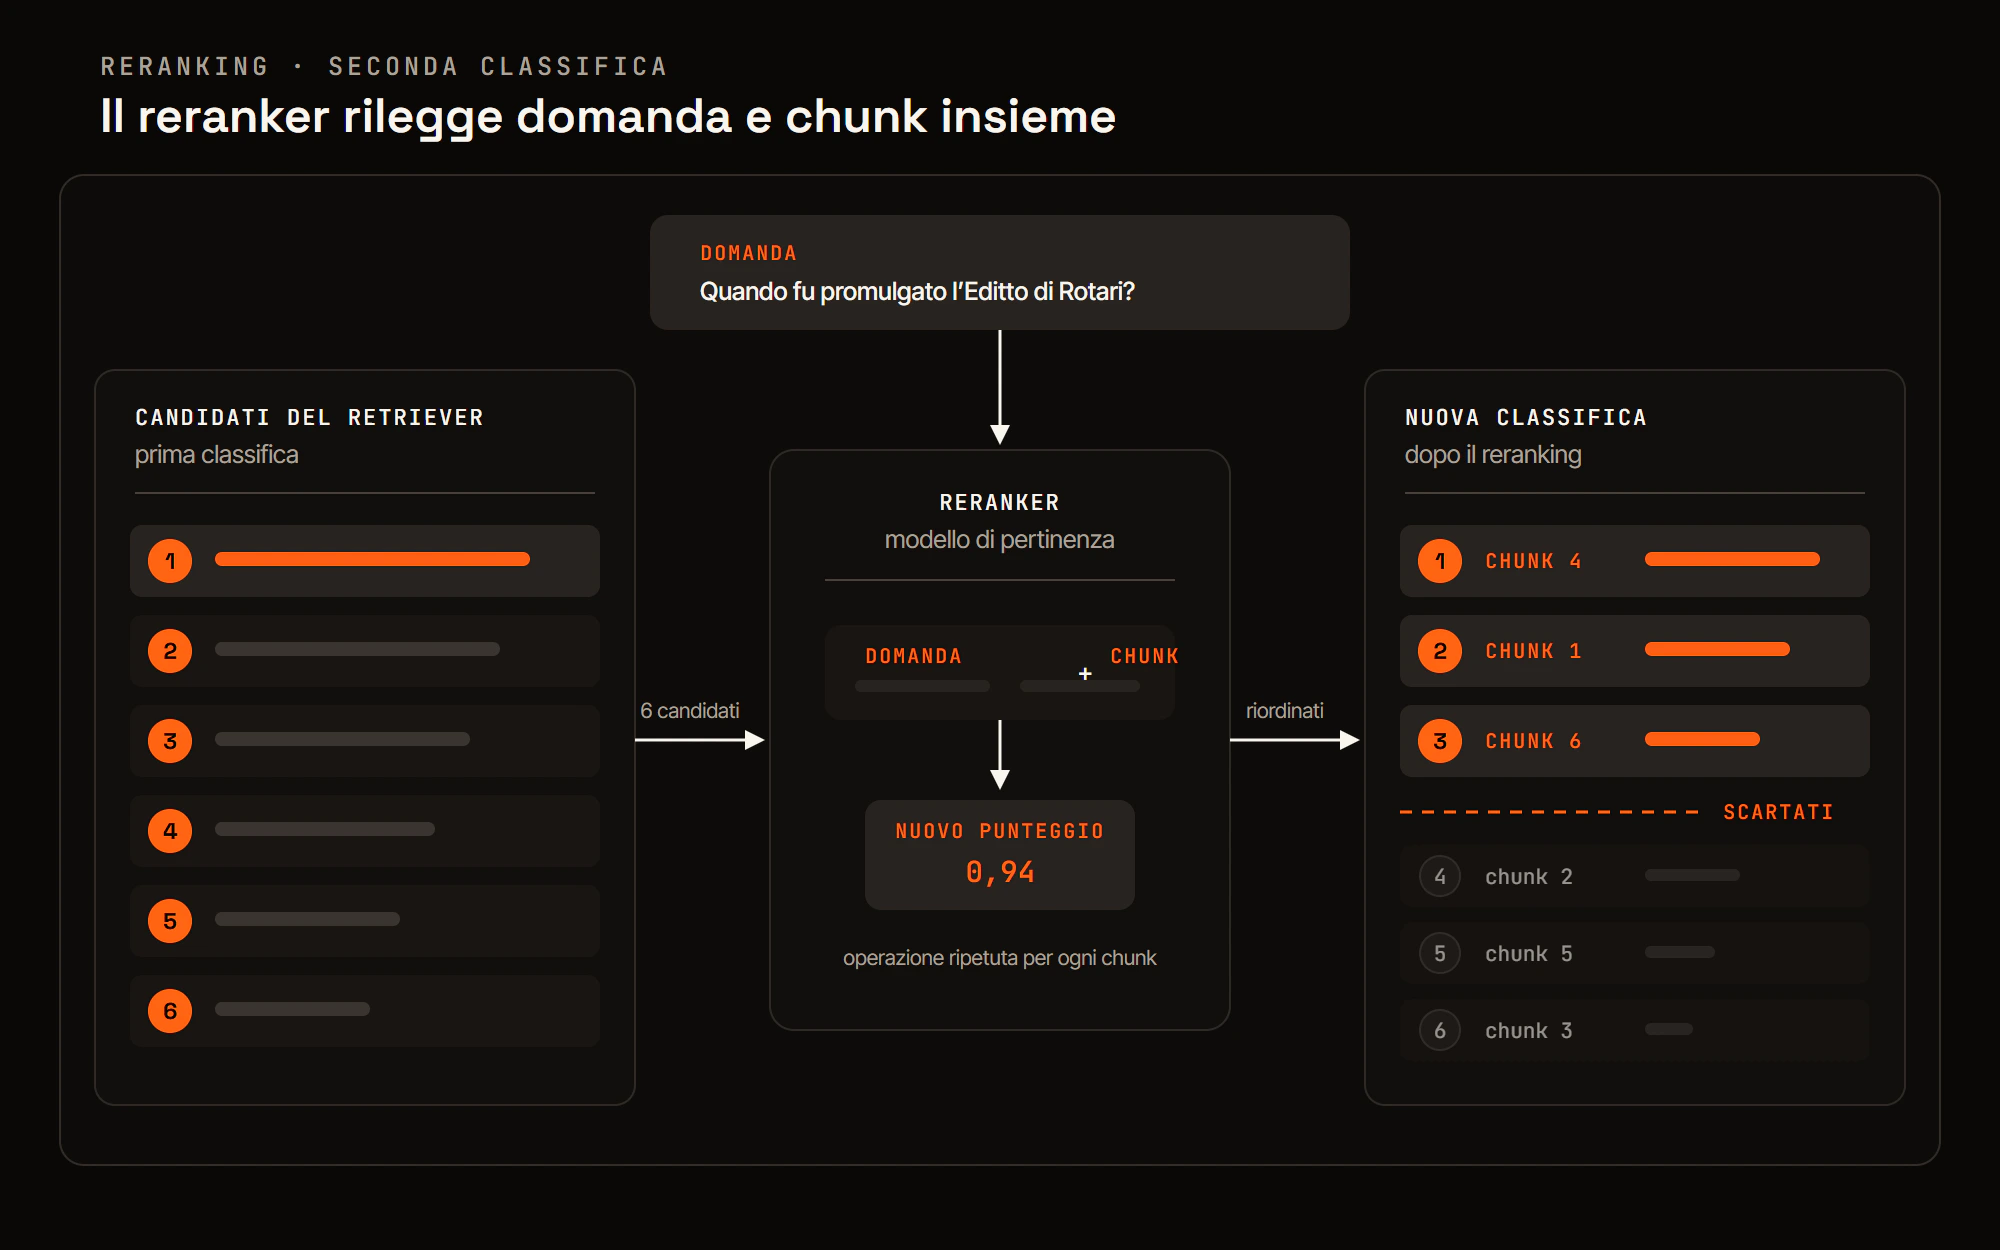
Il reranker non va confuso con il Reciprocal Rank Fusion che abbiamo visto prima. RRF combina le posizioni assegnate da sistemi di ricerca differenti senza rileggere i testi. Il reranker esamina invece nuovamente ogni coppia formata dalla domanda e dal chunk e calcola un nuovo punteggio.
Tra i modelli multilingue disponibili si trovano bge-reranker-v2-m3 e la famiglia Qwen3-Reranker, proposta nelle versioni da 0,6, 4 e 8 miliardi di parametri. Le versioni più grandi richiedono più memoria e tempo di elaborazione e non rappresentano necessariamente la scelta migliore per ogni progetto.
11. Come si costruisce il contesto
La costruzione del contesto è la fase in cui i chunk selezionati dal retrieval e dall’eventuale reranker vengono preparati per essere forniti al modello generativo insieme alla domanda dell’utente.
Il contesto comprende generalmente le istruzioni sul comportamento da seguire, la domanda, i chunk recuperati e gli eventuali metadati. Può includere anche la cronologia della conversazione o altre informazioni necessarie per interpretare correttamente la richiesta.
In forma semplificata, il contenuto inviato al modello potrebbe essere organizzato così.
Istruzioni

Rispondi utilizzando esclusivamente i passaggi forniti.
Se le informazioni non sono sufficienti, dichiaralo.
Indica le fonti utilizzate.

Fonti

[1] Testo del primo chunk
[2] Testo del secondo chunk
[3] Testo del terzo chunk

Domanda

Domanda dell’utente
Al termine del retrieval e dell’eventuale reranking, il sistema dispone di un gruppo di chunk potenzialmente utili. Prima di inviarli al modello deve però organizzarli e adattarli allo spazio disponibile.
La costruzione del contesto non consiste quindi nel copiare i risultati nell’ordine restituito dal retriever. Il sistema può eliminare chunk quasi identici, riunire passaggi provenienti dallo stesso documento, modificarne l’ordine o escludere quelli meno utili. Durante questa operazione può conservare anche metadati come il titolo, l’autore, il numero di pagina e l’indirizzo della risorsa originale, necessari per collegare le informazioni alle rispettive fonti.
La quantità di testo che può essere inserita è limitata dalla finestra di contesto del modello. Istruzioni, domanda, cronologia della conversazione e chunk recuperati devono condividere lo stesso spazio, lasciando anche i token necessari per generare la risposta.
Per questo recuperare più passaggi non significa necessariamente costruire un contesto migliore. Un testo troppo lungo può contenere duplicati, informazioni marginali o fonti in contrasto tra loro e rendere più difficile individuare ciò che serve davvero.
Al termine della selezione, il modello generativo riceve soltanto il contesto così preparato. Con questo passaggio termina il recupero delle informazioni e comincia la generazione della risposta.
12. Come viene generata la risposta
Nell’ultima fase della RAG, il contesto costruito con i chunk recuperati viene inviato al modello insieme alle istruzioni e alla domanda dell’utente.
Il modello riceve questi elementi come un’unica sequenza di testo e genera la risposta un token alla volta. La RAG non modifica i suoi parametri e non aggiunge stabilmente nuove conoscenze. Gli fornisce informazioni esterne soltanto nel momento in cui deve rispondere.
Il modello può riassumere i passaggi, collegare informazioni provenienti da fonti differenti e adattare la spiegazione alla domanda. Se il contesto conserva i riferimenti ai documenti, può utilizzarli anche per indicare le fonti.
La presenza dei chunk corretti non garantisce però che la risposta li rispecchi fedelmente. Il modello può interpretarli male, omettere dettagli o introdurre affermazioni non sostenute dai documenti. Il retrieval determina quali informazioni arrivano al modello, mentre la generazione determina come vengono trasformate nella risposta finale.
12.1. Come viene scelto il token successivo
Per generare il testo, il modello calcola a ogni passaggio un punteggio per tutti i token presenti nel proprio vocabolario. Questi valori vengono trasformati in una distribuzione di probabilità.
Una piccola parte della distribuzione potrebbe apparire così.
- cane 12%
- gatto 8%
- cavallo 3%
- casa 1%
La distribuzione completa comprende in realtà decine di migliaia di token. Il procedimento utilizzato per selezionare la continuazione prende il nome di decodifica.
Il metodo più semplice è la decodifica greedy, che sceglie sempre il token con la probabilità più alta. Questa strategia riduce la variabilità, ma nelle risposte lunghe può produrre testi più rigidi o ripetitivi.
Un’alternativa è il campionamento. Il token viene estratto tenendo conto della distribuzione calcolata dal modello. Quello con la probabilità più alta ha maggiori possibilità di essere scelto, ma non viene selezionato necessariamente. Esecuzioni diverse possono quindi prendere strade differenti fin dai primi token.
La temperatura modifica la distribuzione prima del campionamento. Un valore basso concentra maggiormente la scelta sui token più probabili e rende il risultato più stabile. Un valore alto assegna più spazio anche alle alternative meno probabili, aumentando la varietà e il rischio di produrre passaggi poco coerenti. Molte interfacce interpretano una temperatura pari a zero come una richiesta di decodifica deterministica.
Anche top-k e top-p limitano i token ammessi al campionamento. Top-k conserva soltanto i k token più probabili. Con un valore pari a 20, tutti gli altri vengono esclusi.
Nel retrieval, top-k indica invece quanti chunk vengono restituiti. Il principio è simile, ma le due impostazioni sono indipendenti e agiscono in fasi diverse.
Top-p utilizza una soglia cumulativa. Con un valore pari a 0,9, vengono conservati i token più probabili fino a raggiungere complessivamente almeno il 90%. Il numero dei candidati cambia quindi a ogni passaggio. Saranno pochi quando la probabilità è concentrata e più numerosi quando è distribuita tra molte alternative.
Nei sistemi RAG si utilizzano spesso impostazioni poco variabili, perché l’obiettivo è formulare una risposta aderente alle informazioni recuperate. Una temperatura bassa o una decodifica greedy rendono il risultato più stabile, ma non garantiscono che il modello interpreti correttamente le fonti.
12.2. Perché la stessa domanda può produrre risposte diverse
Disattivare il campionamento e scegliere sempre il token con il punteggio più alto rende la generazione più stabile, ma non garantisce in ogni situazione una risposta identica.
Le reti neurali eseguono un numero enorme di operazioni utilizzando valori numerici con una precisione limitata. Molti calcoli vengono inoltre distribuiti ed eseguiti in parallelo sulle GPU. Piccole differenze nell’ordine delle operazioni possono produrre risultati leggermente diversi.
Normalmente questi scarti non hanno conseguenze visibili. Possono però diventare importanti quando due token ricevono punteggi quasi identici. Una variazione minima può invertire il loro ordine e portare la decodifica greedy a selezionare un token diverso.
Da quel momento si produce un effetto a cascata. Il token scelto viene aggiunto alla sequenza utilizzata per calcolare il successivo. Una differenza iniziale modifica quindi il nuovo input del modello e può condurre il resto della risposta in una direzione differente.
Il risultato può dipendere anche dall’hardware, dalla precisione numerica, dalle librerie utilizzate e dagli algoritmi scelti per eseguire le operazioni. Nei servizi esterni possono cambiare anche la versione del modello o la configurazione dell’infrastruttura.
In un ambiente controllato, con lo stesso modello, lo stesso hardware e operazioni deterministiche, è possibile ottenere risultati molto stabili. Una temperatura pari a zero può eliminare il campionamento, ma non costituisce da sola una garanzia assoluta di riproducibilità.
13. Oltre la RAG tradizionale
Una RAG tradizionale recupera i chunk che sembrano più pertinenti rispetto alla domanda. Questo procedimento funziona bene quando l’informazione richiesta si trova in uno o pochi passaggi, ma incontra maggiori difficoltà quando è necessario ricostruire una visione complessiva o collegare elementi distribuiti tra documenti diversi.
RAPTOR organizza il corpus su più livelli di sintesi. Il sistema raggruppa i chunk in base alla loro somiglianza e genera un riassunto per ciascun gruppo. I riassunti vengono a loro volta raggruppati e sintetizzati, formando una struttura ad albero.
Alla base rimangono i passaggi originali. Nei livelli superiori si trovano rappresentazioni progressivamente più generali del contenuto. Una domanda specifica può essere associata a un chunk originale, mentre una domanda più ampia può recuperare una sintesi collocata più in alto.
Questo permette di cercare informazioni con diversi livelli di dettaglio, ma introduce testi generati automaticamente all’interno dell’indice. Un riassunto può omettere particolari, semplificare eccessivamente oppure introdurre interpretazioni non presenti nelle fonti. Anche la costruzione dell’albero richiede più tempo e risorse rispetto a un’indicizzazione tradizionale.
HippoRAG si ispira ai meccanismi associativi della memoria umana. Il sistema estrae entità e relazioni dai documenti, le organizza in un knowledge graph e utilizza Personalized PageRank per individuare i collegamenti più rilevanti rispetto alla domanda.
La ricerca non dipende quindi soltanto dalla somiglianza tra la domanda e un singolo chunk. Il sistema può seguire relazioni tra persone, luoghi, eventi e concetti, anche quando le informazioni necessarie si trovano in documenti differenti. Questo approccio è particolarmente adatto alle domande che richiedono più passaggi logici.
La sua efficacia dipende però dalla qualità delle entità e delle relazioni estratte. Un collegamento mancante o errato può interrompere il percorso verso l’informazione corretta, mentre la costruzione e l’aggiornamento del grafo aggiungono complessità alla pipeline.
La RAG agentica non identifica un singolo algoritmo, ma una famiglia di sistemi nei quali il modello può controllare parte del processo di ricerca.
In questi sistemi il modello può scomporre una domanda complessa, scegliere quali strumenti interrogare, esaminare i risultati e decidere se effettuare nuove ricerche.
Il processo diventa quindi iterativo. Una prima ricerca può fornire informazioni utili per formulare la successiva, mentre risultati insufficienti possono indurre il sistema a cambiare query o fonte.
Questa flessibilità aumenta però i tempi, i costi e la difficoltà di controllo. Una decisione sbagliata può condurre a ricerche inutili, mentre un’informazione interpretata male può influenzare tutti i passaggi successivi. Per domande semplici, una pipeline tradizionale rimane spesso più rapida, prevedibile e adeguata.
14. La risposta è solo l’ultimo passaggio
Al termine di questo percorso, la risposta generata appare come la parte più evidente della RAG, ma non è necessariamente quella che rivela meglio il funzionamento del sistema. Un testo chiaro e convincente può nascondere una ricerca incompleta, una fonte poco pertinente o un collegamento costruito dal modello senza un reale sostegno nei documenti.
Valutare soltanto la risposta finale non è quindi sufficiente. Bisogna poter esaminare quali passaggi sono stati recuperati, da quali documenti provengono e come sono stati utilizzati.