Segnatura è una libreria Python che legge ed estrae il testo di un file EPUB e ne classifica il contenuto in blocchi distinguibili in base alla loro funzione editoriale (testo dell’opera, nota, bibliografia, indice e paratesto) e preserva coordinate EPUB stabili per le citazioni e il recupero dei dati a valle.
La libreria è pensata per costruire un sistema di retrieval su una biblioteca di saggistica in formato EPUB. Molte pipeline di estrazione generiche appiattiscono il contenuto dell’EPUB, mescolando note, bibliografie, indici e capitoli, rendendo difficile il lavoro del retrieval. Segnatura li tiene distinti e conserva per ciascun blocco la sua posizione esatta dentro il file, permettendo quindi una citazione rigorosa della fonte.
Il processo di estrazione è deterministico e procede decidendo blocco per blocco, usando le informazioni presenti nel file EPUB: marcature semantiche, indice di navigazione, struttura dei collegamenti fra richiami e note. Inoltre, un insieme di regole strutturali, ognuna con un identificatore stabile, permette di individuare anche i blocchi che non presentano indicazioni o si prestano a fraintendimenti.
Per capire il motivo per il quale è stato necessario inserire tutte queste regole, dobbiamo fare un piccolo passo indietro e partire dal formato del file.
Il codice sorgente e la documentazione sono disponibili nel repository GitHub di Segnatura.
Segnatura non esegue OCR né decifra EPUB protetti da DRM e non sostituisce un database vettoriale o un sistema RAG completo.
Com’è fatto un EPUB
Un EPUB è un archivio compresso che contiene documenti XHTML, un file che ne dichiara l’ordine di lettura e, di solito, un indice di navigazione. Non c’è un file “testo del libro”: c’è una sequenza di documenti che un lettore apre uno dopo l’altro.
Lo standard prevede un modo per dichiarare la funzione di ciascuna parte: esistono attributi appositi per dire «questa è una nota», «questa è la bibliografia», «qui comincia il corpo del volume». Nel corpus esaminato, queste dichiarazioni comparivano soltanto in una parte degli EPUB ed erano spesso incomplete.
Quello che resta sono indizi indiretti. Il titolo che l’indice di navigazione assegna a un documento. Il nome del file. La forma del contenuto: paragrafi lunghi e discorsivi da una parte, righe brevissime piene di numeri di pagina dall’altra. E soprattutto la struttura dei collegamenti: una nota, in un EPUB fatto bene, è puntata da un richiamo nel testo e a sua volta rimanda indietro. Quella coppia di collegamenti reciproci è una firma indipendente dalla lingua e utilizzabile per comprendere il tipo di blocco.
Da qui si capisce perché utilizzare un semplice filtro che scarta i blocchi il cui nome o titolo contiene indice, bibliografia o copyright funziona solo in parte. Come abbiamo avuto modo di sperimentare, ci sono almeno tre situazioni in cui non è la soluzione più efficiente:
- quando un capitolo contiene le proprie note in fondo, prenderlo o scartarlo è comunque sbagliato per metà del contenuto;
- quando il libro è stato convertito da un altro formato, i documenti si chiamano tutti
index_split_xx.htmle non c’è nessun appiglio lessicale; - quando l’editore intitola una sezione «Note e riferimenti bibliografici», una singola parola chiave non basta a decidere se sono note o bibliografia, che sono due cose con destini diversi.
Segnatura interviene proprio lì: decide per blocco, non per file, e quando gli indizi si contraddicono applica regole ordinate secondo una precedenza dichiarata, conservando l’identificatore di quella utilizzata. Si può sapere quale regola ha determinato la classificazione e quali elementi strutturali l’hanno sostenuta.
Le coordinate EPUB per il RAG
La seconda caratteristica principale della libreria è mantenere le coordinate di ogni blocco estratto dall’EPUB. Il punto non è solo poter risalire al passaggio, ma rendere quelle coordinate indipendenti da come il testo verrà suddiviso a valle (chunk), e questa differenza si vede quando si costruisce un sistema di retrieval.
In un RAG il testo viene tagliato in porzioni, ciascuna trasformata in un vettore e messa in un indice. La ricerca restituisce porzioni. Ma quelle porzioni sono il prodotto di scelte arbitrarie: quanti token usare e quanto deve essere grande l’overlap lo decide l’utente. L’identificativo di una porzione, quindi, non è un riferimento stabile: dopo una reindicizzazione non esiste più.
Segnatura non lega la citazione al chunk. Ogni unità e ogni passaggio conserva un intervallo nella sorgente originale, formato dal documento XHTML, dall’XPath, dagli offset iniziale e finale e da impronte di verifica. Queste coordinate appartengono all’EPUB, non all’indice, e quindi non cambiano quando il testo viene nuovamente suddiviso in chunk. Il chunk è soltanto il veicolo usato per il recupero: quando salvi una citazione, salvi l’intervallo sorgente, non l’identificatore del chunk.
Ne conseguono tre cose pratiche:
- le citazioni salvate restano valide attraverso le reindicizzazioni, finché l’EPUB resta identico. Se hai messo da parte la fonte di una risposta e sei mesi dopo hai ricostruito l’indice tre volte, quel riferimento continua ad aprire il libro nel punto giusto;
- cambiare modello di embedding costa meno di quanto sembri. I vettori vanno ricalcolati, su quello non si scappa. Estrazione, classificazione e coordinate possono essere riutilizzate; i chunk restano uguali solo mantenendo invariati tokenizer e parametri di chunking. E siccome le porzioni sono identiche nei due indici, il confronto isola davvero il modello invece di misurare insieme modello e suddivisione;
- l’impronta del testo fa da controllo. Se il file è stato sostituito, la rilettura lo evidenzia.
Fuori da un RAG vale lo stesso, solo che il calcolo avviene sul momento. Chiami l’estrazione e le coordinate sono già dentro le unità che ricevi. Il punto d’arrivo è identico, perché il riferimento è sempre direttamente all’EPUB.
Benchmark della libreria
Segnatura è stata valutata in due esperimenti controllati distinti, entrambi su corpora italiani.
Accuratezza della classificazione
100 blocchi presi da 10 file EPUB sono stati etichettati a mano confrontandoli con l’originale impaginato, tenendo nascosta la previsione di Segnatura durante l’annotazione. I 100 blocchi si dividono in due gruppi. 50 sono stati estratti a caso dall’intero corpus, e su questi la categoria assegnata da Segnatura ha coinciso con l’etichetta umana in 45 casi. Gli altri 50 sono casi “difficili”, scelti nei punti dove la classificazione è ambigua, cioè note in coda a un capitolo senza alcuna marcatura che le dichiari tali, titoli privi di dichiarazione semantica, voci bibliografiche dentro un documento che contiene anche testo dell’opera, blocchi in cui i segnali strutturali si contraddicono fra loro. Su questi la corrispondenza è stata di 48 su 50.
Complessivamente l’accuratezza è 93 su 100, e 99,65% se pesata sui caratteri, perché la maggior parte degli errori riguardava blocchi brevi. Trattandosi in metà dei casi di blocchi scelti perché difficili, il risultato complessivo vale come riferimento per verificare le regressioni del classificatore su un insieme limitato di EPUB ed editori italiani, non come stima di accuratezza su un libro qualunque.
Effetto sul recupero delle informazioni
Il secondo esperimento misura l’efficacia di Segnatura rispetto ad altre librerie che utilizzano il seguente approccio: l’analisi di tutti i documenti XHTML contenuti nell’EPUB e la selezione del testo in base al nome dei file o al titolo che si trova nell’indice di navigazione. Di solito tutto quello che contiene parole come copertina, sommario, indice, bibliografia, copyright o ringraziamenti viene scartato.
L’esperimento è stato condotto in parallelo sui due sistemi utilizzando gli stessi 50 file EPUB, con impostazioni identiche di suddivisione in segmenti (chunking), embedding e ricerca vettoriale.
Per valutare il comportamento dei due diversi approcci è stato necessario creare 300 domande, così divise:
- il primo gruppo raccoglie domande ordinarie, lunghe e argomentative, come «Come cambiò il significato del termine laeti tra il III e il IV secolo, e quale funzione ebbero i laeti nella politica romana di insediamento e reclutamento?»;
- il secondo raccoglie query brevi che mettono in concorrenza testo e apparato sullo stesso termine, come «Chi erano i laeti?».
La distinzione serve perché le due forme si comportano in modo opposto. Nella domanda lunga il maggiore contesto semantico riduce fortemente la capacità di una voce di indice o bibliografica di competere con il paragrafo pertinente.
Nella query breve la situazione si rovescia. Il retriever premia le porzioni di testo che somigliano di più alla domanda, e una voce di indice o di bibliografia è corta e non contiene altro che il termine cercato, quindi è un candidato più forte del paragrafo che tratta quell’argomento. Il secondo gruppo di domande è stato costruito per creare questa situazione, scegliendo termini presenti tanto nel testo quanto negli apparati.
I 6 risultati migliori di ogni interrogazione, provenienti da entrambi i sistemi, sono stati mescolati e valutati secondo criteri fissi da un modello linguistico che non sapeva da quale sistema venissero, in che posizione fossero arrivati né con quale punteggio.
Query con collisione editoriale
| Metrica | Riferimento | Segnatura | Differenza | Intervallo di confidenza al 95% |
|---|---|---|---|---|
| Fonte registrata recuperata nei primi 6 risultati ↑ | 68,71% | 74,15% | +5,44 punti | da +1,36 a +10,20 |
| Passaggi contenenti la risposta o concretamente utili ↑ | 51,47% | 55,10% | +3,63 punti | da +1,81 a +5,78 |
| Query con almeno un passaggio di solo apparato nei primi 6 risultati ↓ | 48,30% | 29,25% | -19,05 punti | da -26,53 a -11,56 |
| Passaggi di solo apparato sul totale delle posizioni recuperate ↓ | 13,38% | 6,58% | -6,80 punti | da -9,86 a -4,08 |
↑ valori più alti sono migliori; ↓ valori più bassi sono migliori.
Le differenze sono espresse in punti percentuali tra proporzioni ottenute dai due sistemi sullo stesso insieme di domande; il valore nullo è quindi zero. Gli intervalli di confidenza al 95% sono intervalli bootstrap a percentili, ottenuti ricampionando i 50 libri. La loro ampiezza indica che l’entità precisa degli effetti resta incerta, anche se nelle domande con collisione editoriale gli intervalli riportati non comprendono lo zero.
Domande ordinarie
| Metrica | Riferimento | Segnatura | Differenza |
|---|---|---|---|
| Fonte registrata recuperata nei primi 6 risultati ↑ | 92,67% | 92,00% | -0,67 punti |
| Passaggi contenenti la risposta o concretamente utili ↑ | 77,11% | 79,00% | +1,89 punti |
| Passaggi di solo apparato ↓ | 6,00% | 4,11% | -1,89 punti |
↑ valori più alti sono migliori; ↓ valori più bassi sono migliori.
Dimensione dell’indice del testo dell’opera
| Indicatore | Variazione rispetto al riferimento |
|---|---|
| Record ricercabili | -5,61% |
| Token indicizzati | -6,33% |
Segnatura ha quindi migliorato il recupero nelle query esposte a collisione editoriale e ridotto la presenza dell’apparato fra i risultati. Sulle domande ordinarie il recupero della fonte è rimasto sostanzialmente invariato. Il risultato è stato ottenuto con un indice del testo dell’opera più piccolo, mentre note, bibliografie, indici e paratesti sono rimasti disponibili nelle rispettive categorie.
Il quadro complessivo indica una base di ricerca più pulita e più efficace su questo corpus italiano, con il vantaggio concentrato sulle domande esposte alla concorrenza fra testo e apparato. Non implica un recupero migliore su ogni EPUB, lingua, formulazione, modello di embedding o sistema di ricerca.
Profilo dell’edizione, l’applicazione in locale
Insieme alla libreria viene distribuita una piccola applicazione che gira nel browser, in locale, e serve a due cose: guardare come è stata fatta la classificazione di un libro ed eventualmente correggerla.
Nell’applicazione è possibile attivare un LLM (in locale o esterno) che revisiona la classificazione completa usando documenti, blocchi ed estratti preparati da Segnatura e segnala i punti in cui sono presenti ambiguità, proponendo una correzione.
L’utente può valutare la bontà dei suggerimenti e decidere se applicarli. Nessun suggerimento entra nel profilo senza una decisione esplicita. L’utente può anche scegliere di revisionare manualmente tutto il file.
Le correzioni approvate non modificano l’EPUB e possono essere salvate in un file JSON, il cosiddetto profilo dell’edizione, legato a quel preciso file tramite la sua impronta. Passandolo a una successiva estrazione, le correzioni vengono applicate solo se il libro è ancora esattamente quello.
Nei paragrafi che seguono vediamo come si usano la libreria e l’applicazione.
Tutorial
Installazione e primi comandi
python -m pip install segnaturaSegnatura usa soltanto la libreria standard di Python. Per l’applicazione locale serve un componente in più:
python -m pip install "segnatura[tools]"Il comando più semplice estrae il testo dell’opera:
segnatura libro.epub --output testo.txtLe altre categorie si chiedono esplicitamente, da sole o in combinazione:
segnatura libro.epub --category bibliography --output bibliografia.txt
segnatura libro.epub --category work_text --category note --output con-note.txt
segnatura libro.epub --category all --format units-json --output tutto.json
Da Python
from segnatura import extract

book = extract("libro.epub")

testo = book.text()
con_note = book.text(categories={"work_text", "note"})

for unit in book.units(categories={"bibliography"}):
    print(unit.text)
Per un sistema di retrieval, il formato dedicato produce record già pronti per un database vettoriale, ciascuno con testo, categoria, identità del libro e coordinate della fonte:
segnatura libro.epub --format rag-jsonl --output libro.jsonlE la verifica di una citazione:
for hit in book.find_text("Editto di Rotari", categories="all"):
    print(hit.source["href"], hit.source["start"]["xpath"])
    print(book.verify_source(hit.source))   # True finché l'EPUB non cambia
L’applicazione: profilo dell’edizione
Per avviare l’applicazione:
segnatura-edition-profile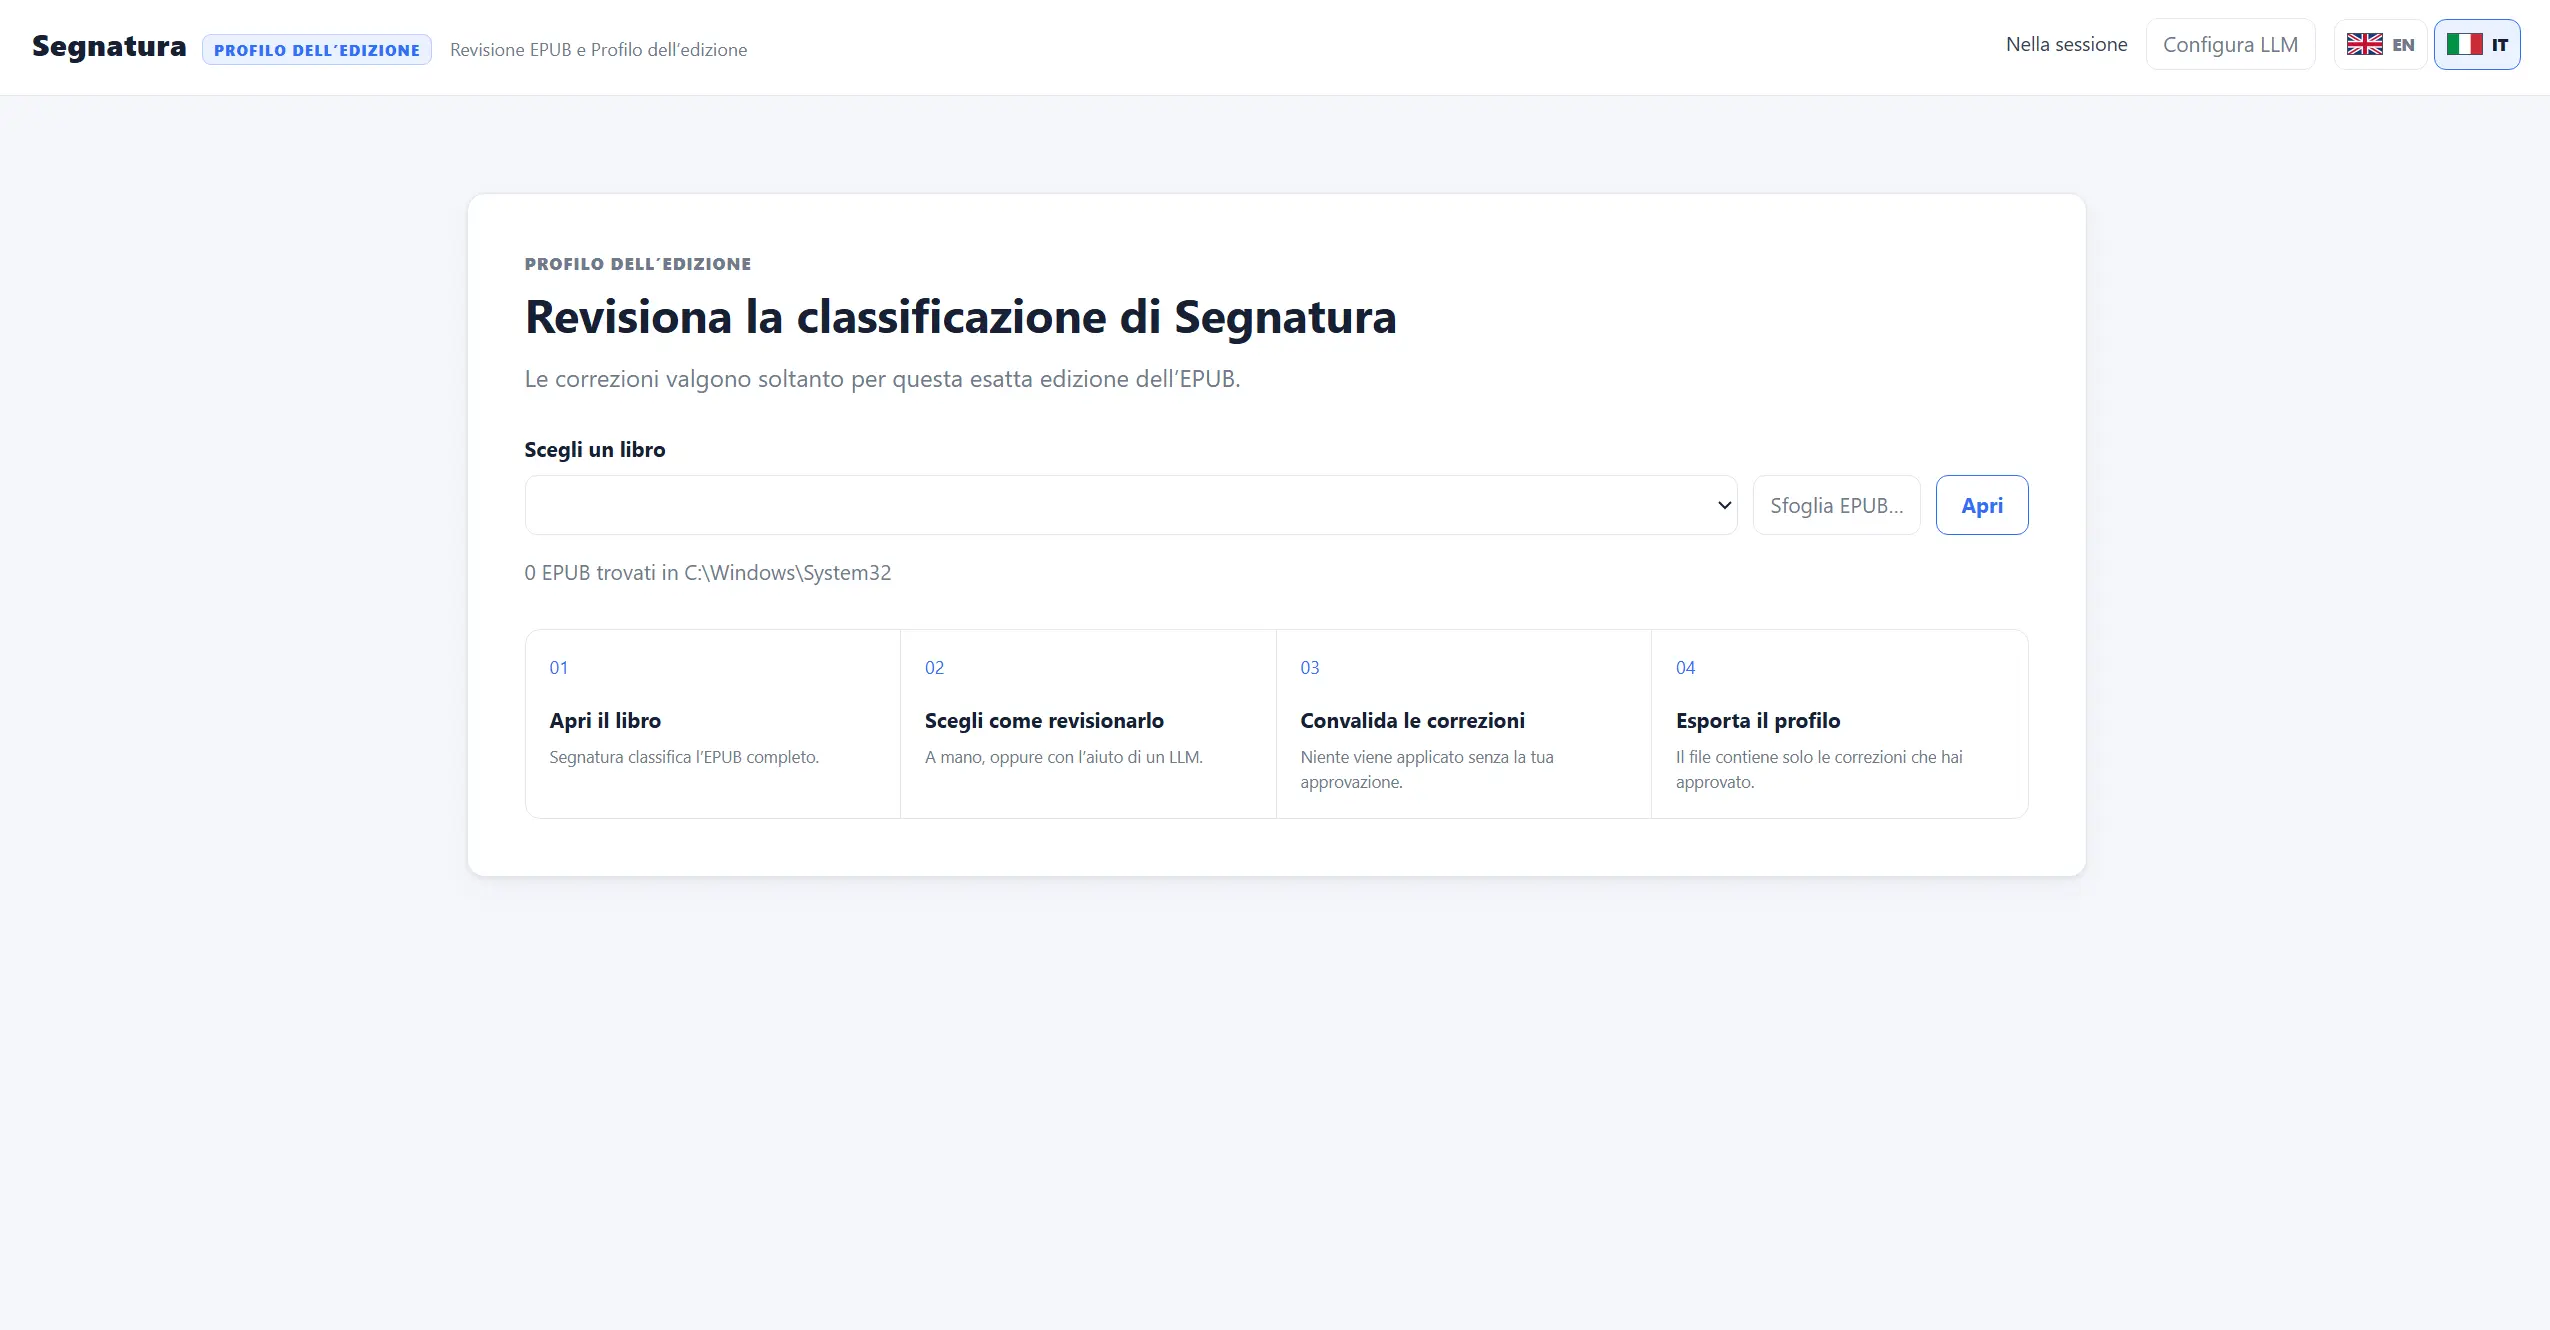
Fig. 1. Schermata iniziale dell’applicazione.
Avvia l’applicazione e scegli un EPUB.
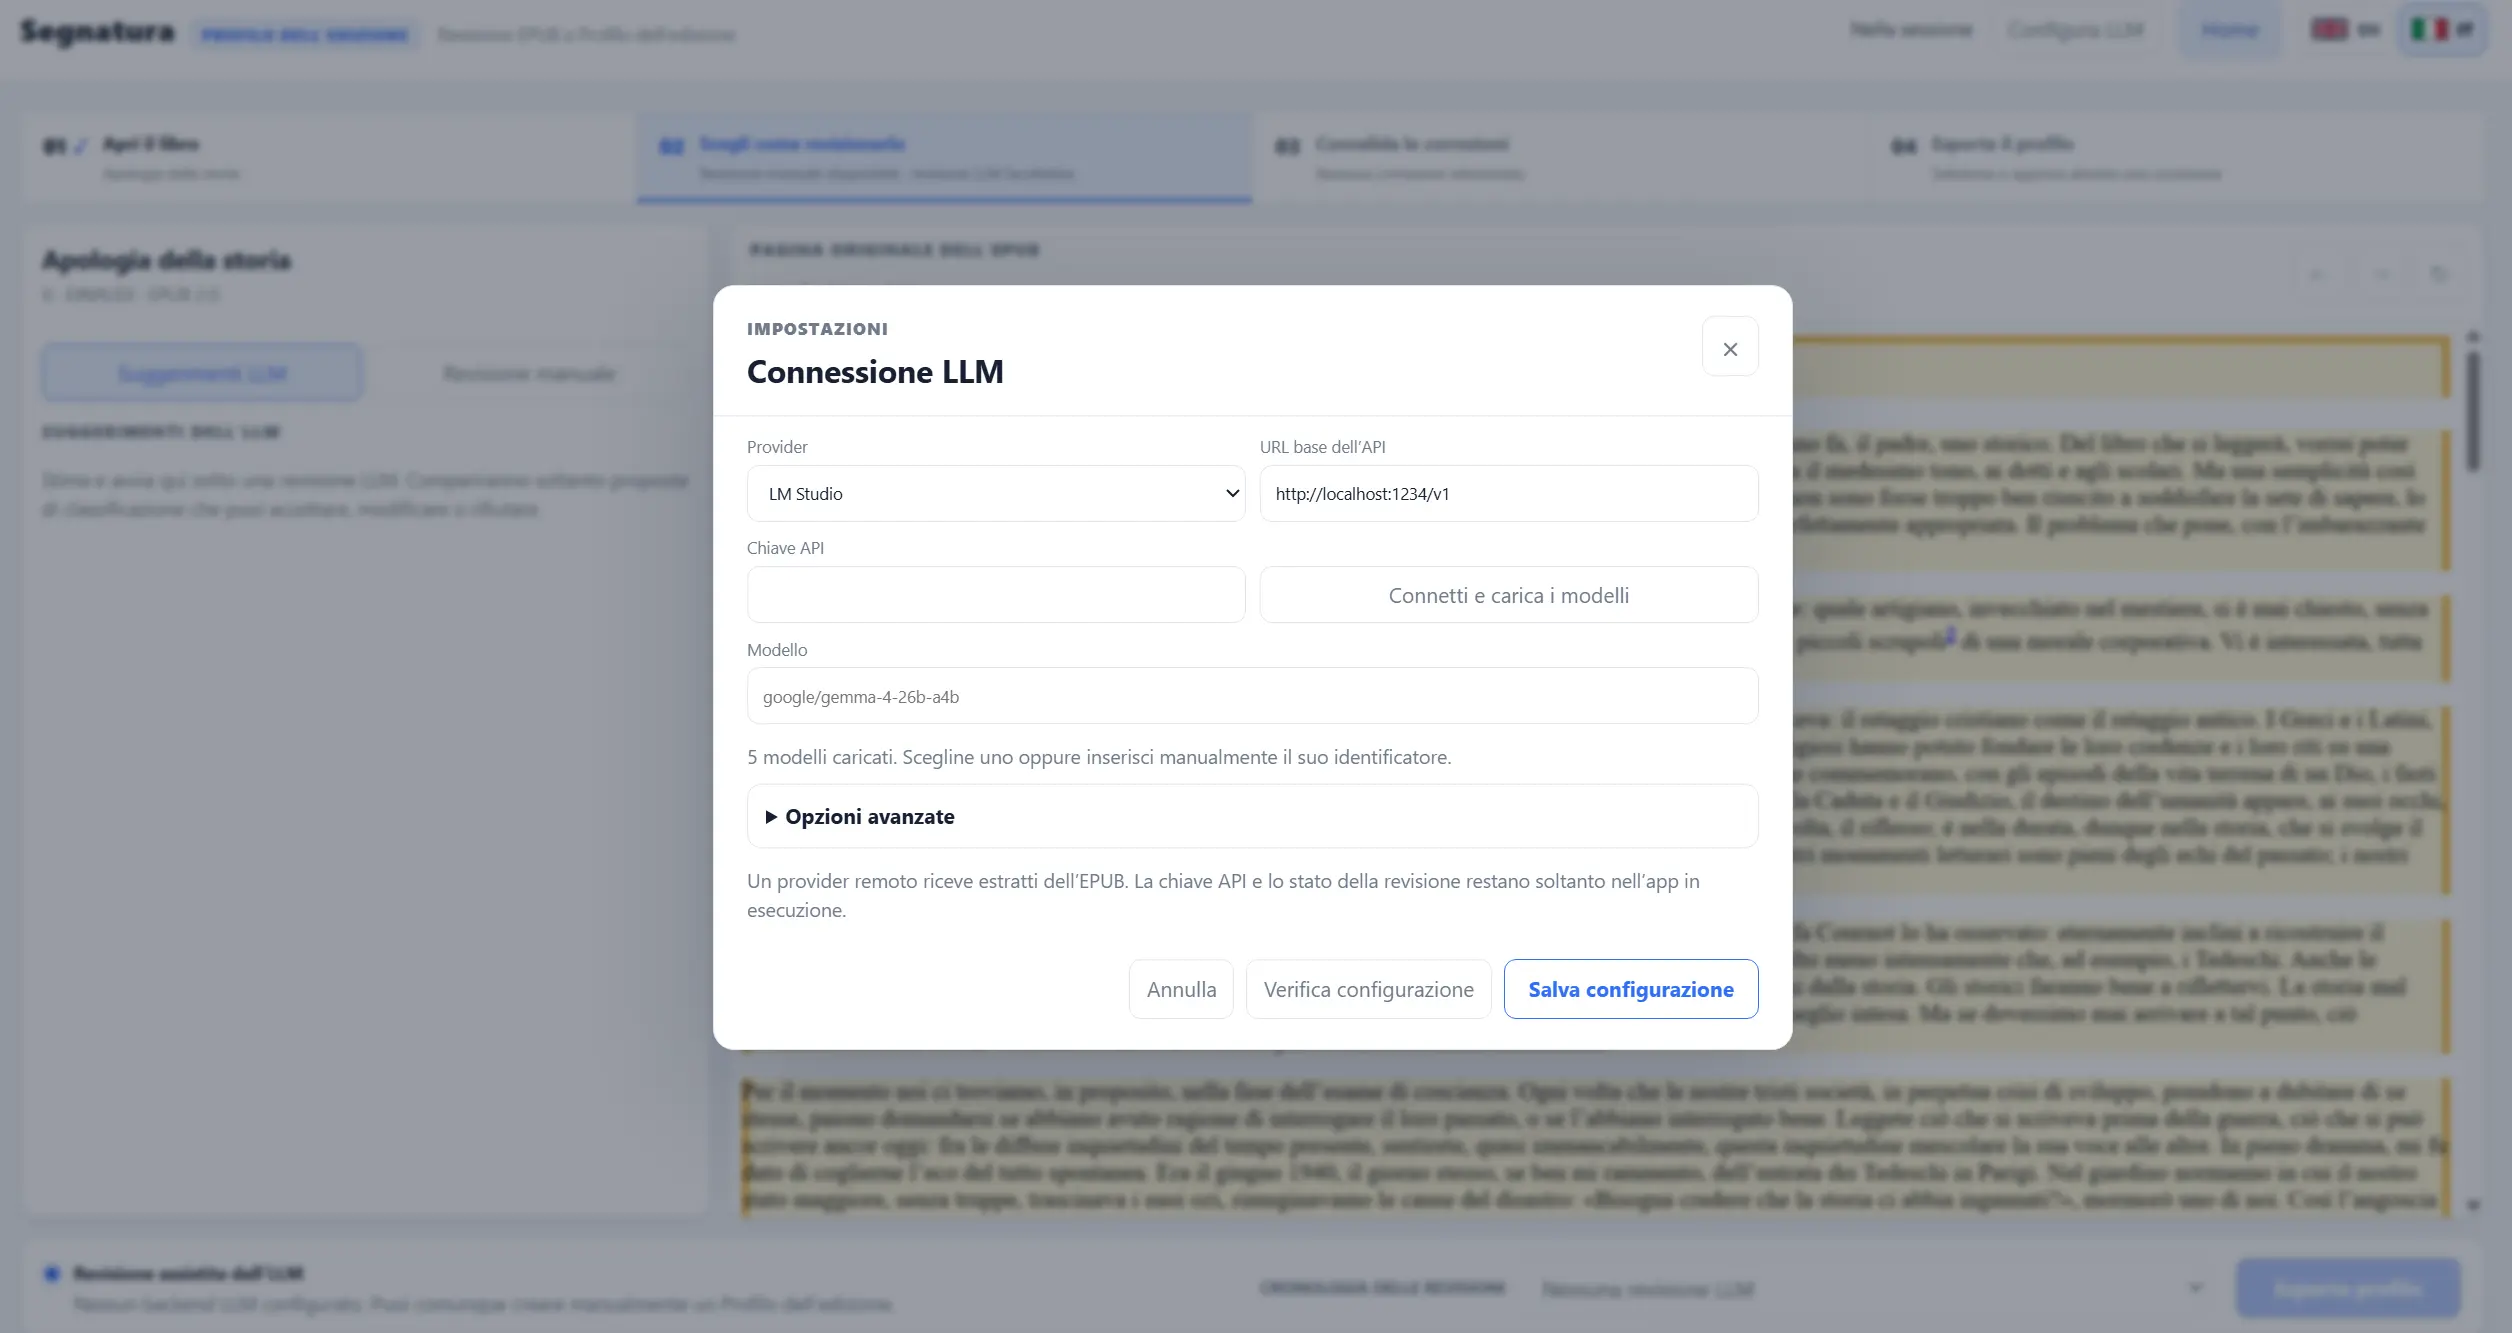
Fig. 2. Configurazione del modello LLM.
Clicca su Configura LLM e scegli il provider, locale o tramite API esterna. Cliccando su Connetti e carica i modelli verrà effettuata una chiamata e saranno elencati i modelli disponibili, quando l’API lo permette. Seleziona il modello e salva la configurazione.
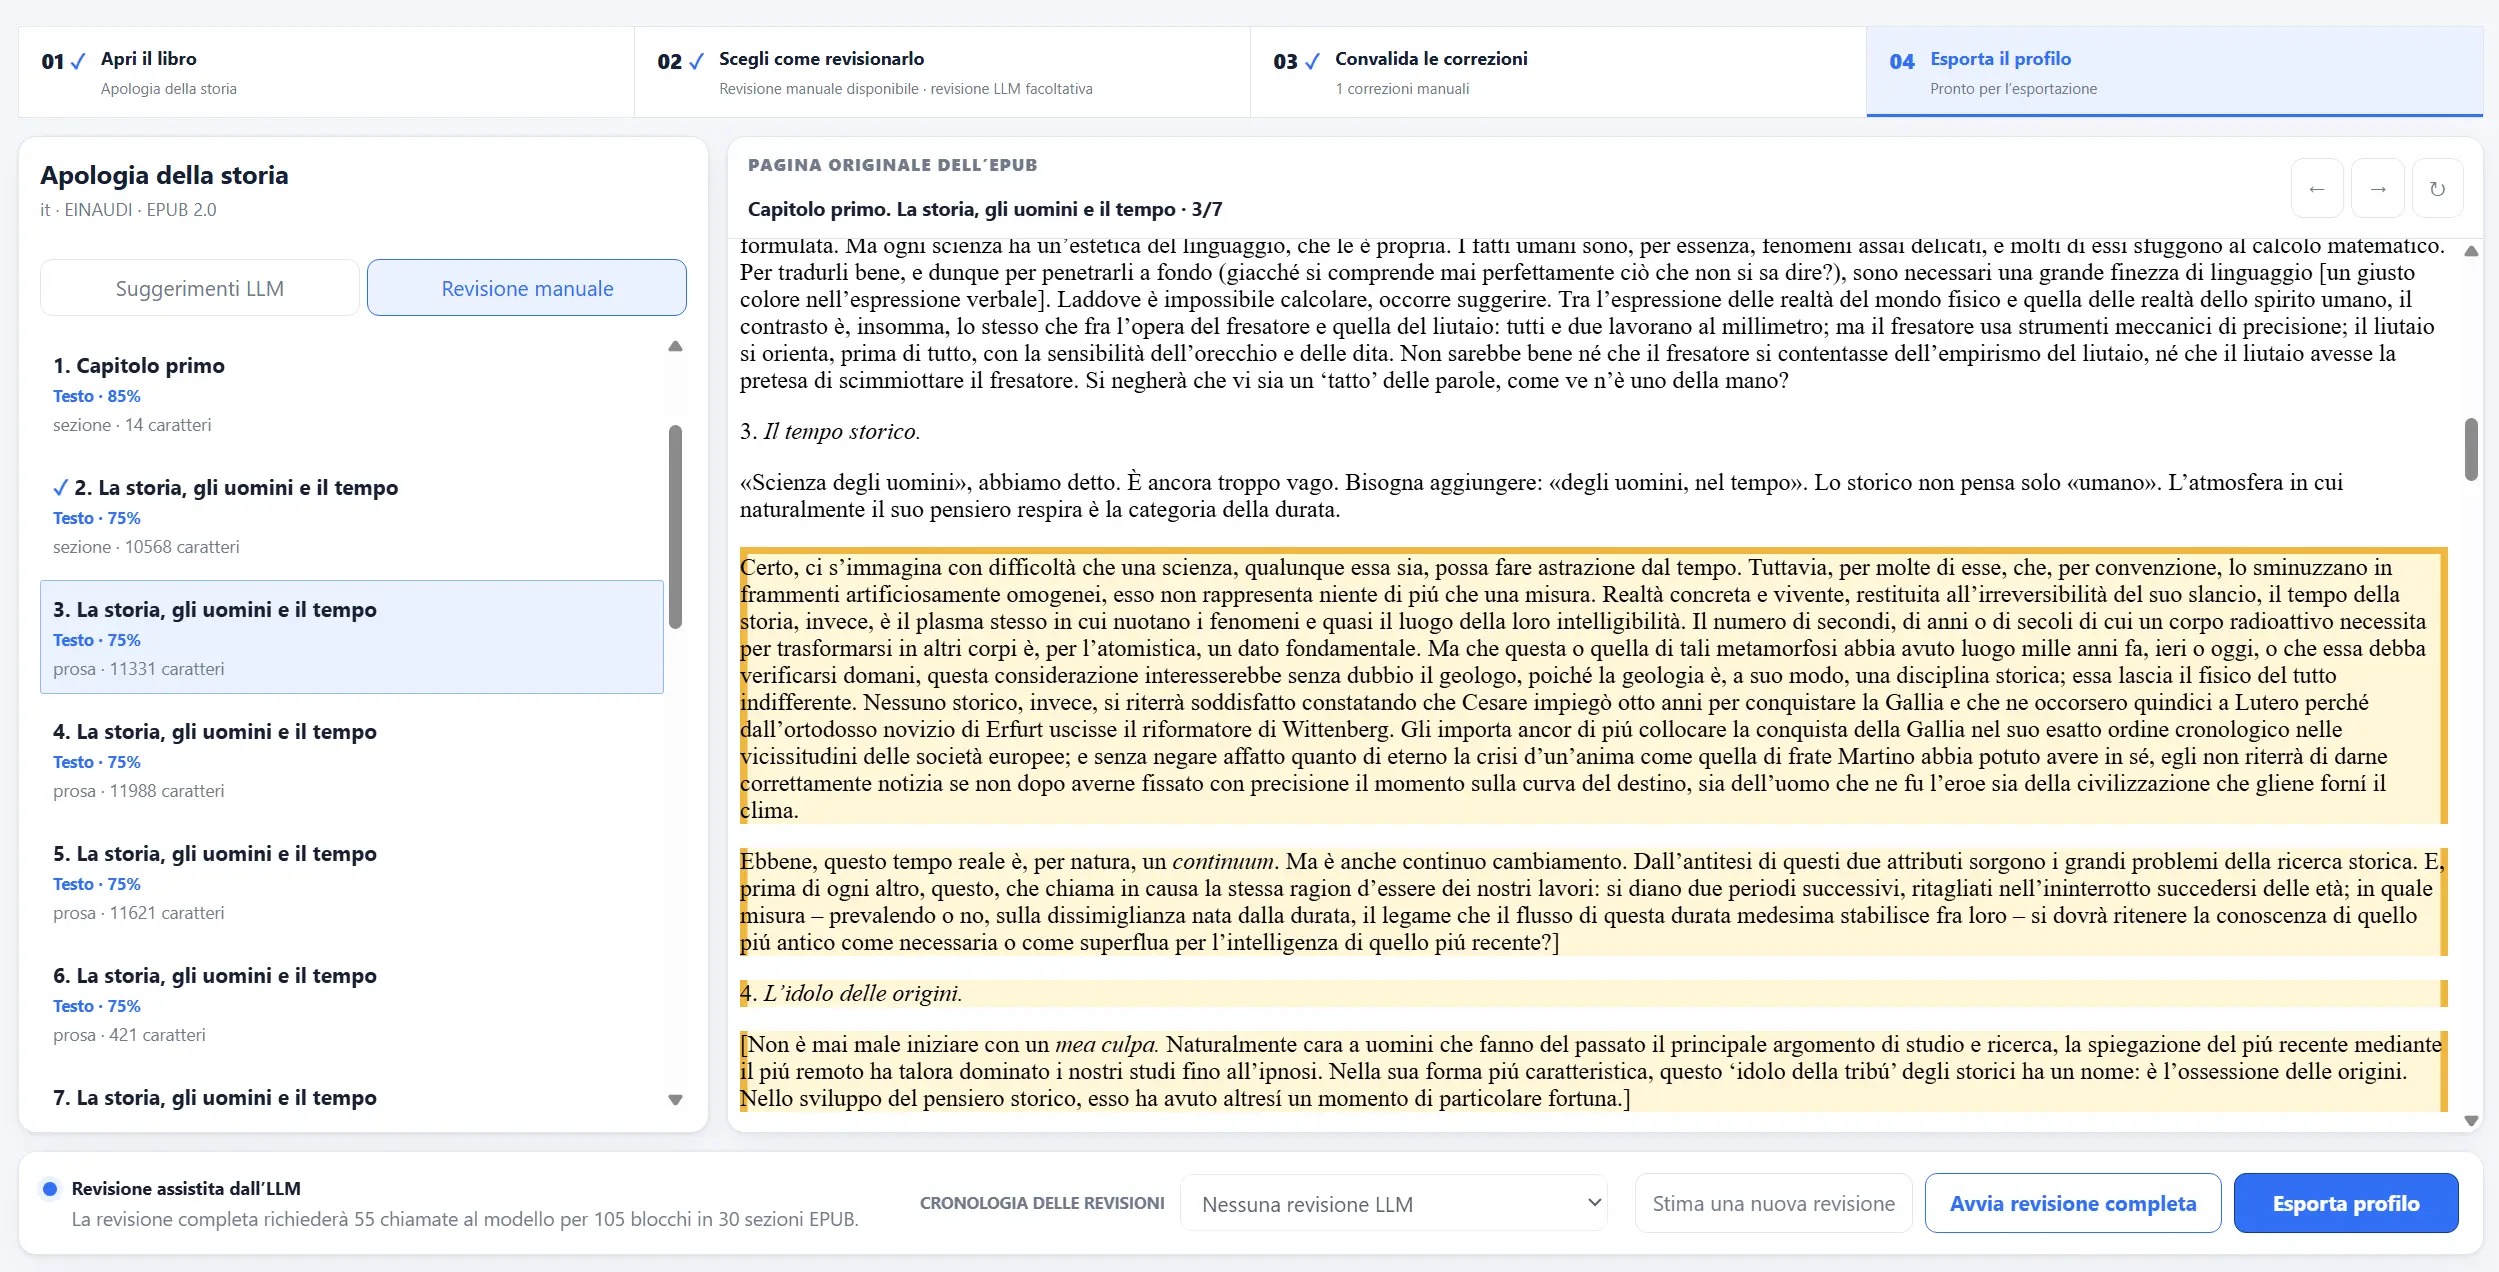
Fig. 3. Pannello di revisione e indice dei blocchi.
Il menu a sinistra permette di selezionare i blocchi per l’analisi e la modifica manuale.
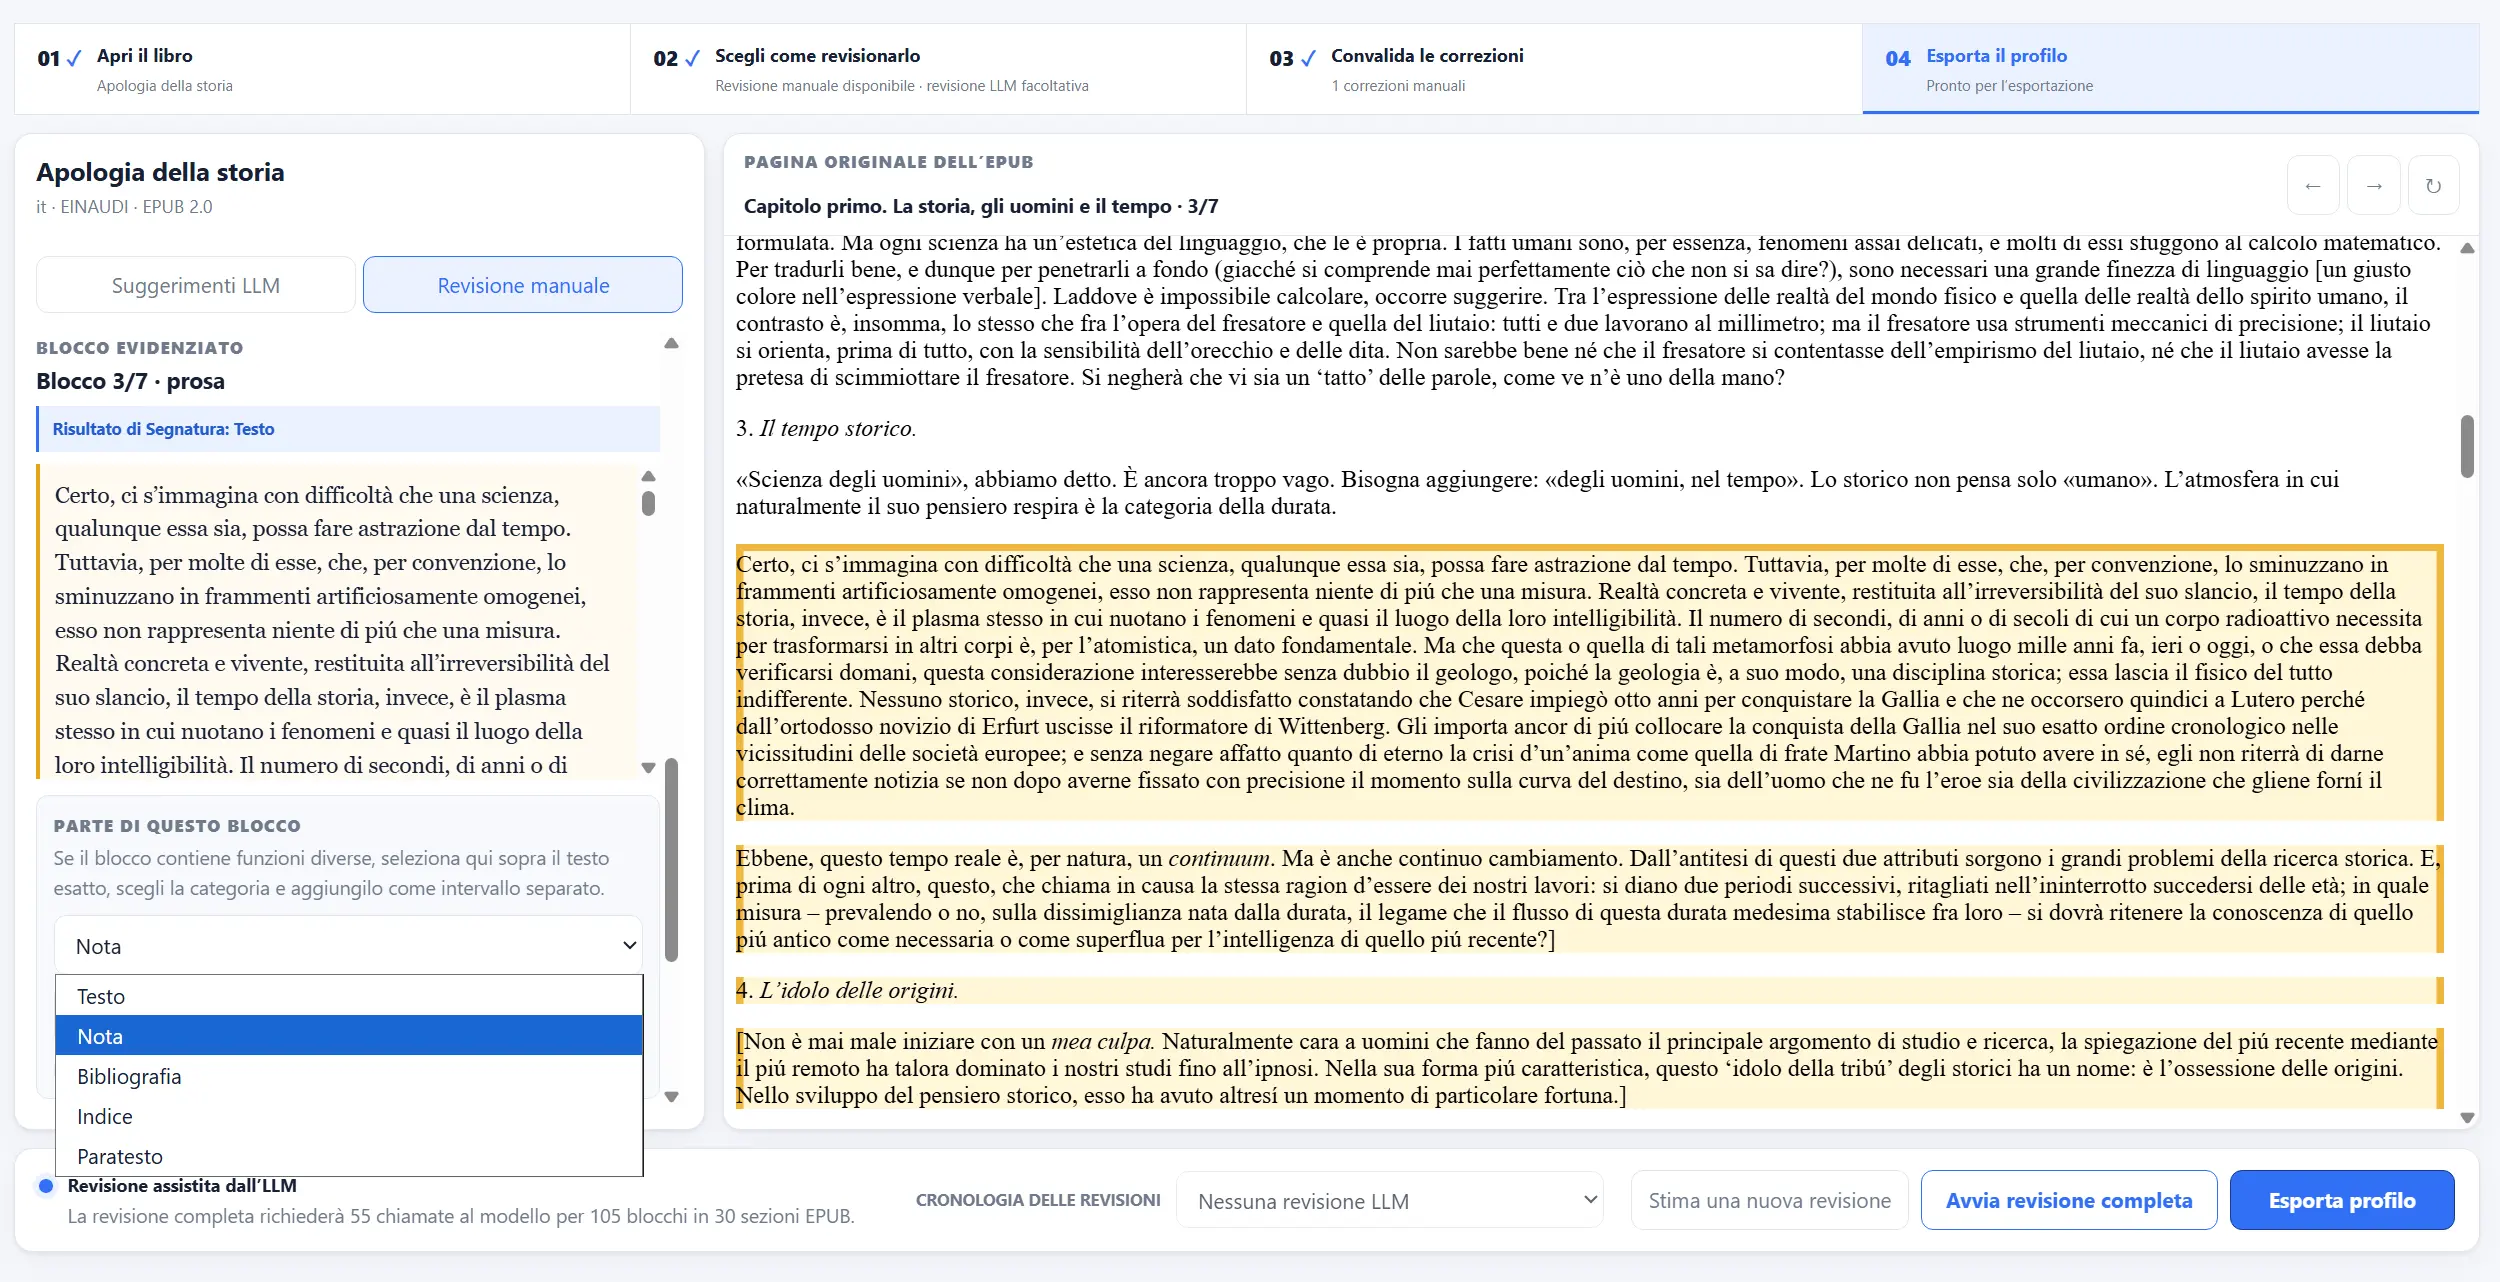
Fig. 4. Modifica della categoria di un blocco.
Sempre dal menu a sinistra si può modificare il blocco scegliendo tra testo, nota, bibliografia, indice e paratesto.
Cliccando su Esporta profilo verrà salvato un file JSON. Per passarlo all’estrazione si esegue:
book = extract(
    "libro.epub",
    edition_profile="libro.segnatura.json",
)
Il modo più rapido per farsi un’idea è estrarre bibliografia e indici da un saggio che si conosce bene. Sono le due categorie in cui un errore si vede a colpo d’occhio, perché sai già cosa dovrebbe esserci dentro e cosa no.
Le regole di classificazione sono state calibrate soprattutto su editoria italiana e inglese, con supporto parziale per francese, tedesco e spagnolo. Su altre lingue può rendersi necessario un profilo dell’edizione.